Duplikált leadek a CRM-ben
Így teszi rendbe a data governance a sales pipeline-t
- AI az üzletben
A saleses vezetőknek kevesebb mint a fele bízik a saját előrejelzésében, és az egyik legcsendesebb ok magában a CRM-ben rejlik: ugyanaz a vevő többször szerepel benne, többféle írásmóddal és számos tulajdonossal. Ez a cikk végigveszi, mibe kerül ez a többszöröződés pénzügyi értelemben és hogyan lehet úgy rendet tenni az adatok között, hogy a szabályozás egy negyedévnél tovább is kitartson.
A Gartner State of Sales Operations felmérése szerint a saleses vezetőknek és a saleses alkalmazottaknak mindössze 45%-a bízik igazán abban, hogy a saját szervezete előrejelzése pontos. A felmérés a gyenge adatminőséget nevezi meg az egyik fő okként: a válaszadók 47%-a tartotta jó minőségűnek a cége adatait, 13%-a pedig kifejezetten rossznak minősítette őket. A Gartner három tényezőt nevez meg az alacsony adatminőség hátterében, és az egyik éppen a data governance hiánya: a szervezetek nagy részében nincsenek a CRM céljaiból levezetett, elfogadott adatminőségi követelmények.
A data governance megléte vagy hiánya dönti el, hogy a pipeline-tisztítás tartósan működik-e vagy néhány hónap múlva kezdődik elölről. A duplikátumok összevonása egyetlen hétvége munkája. Az viszont, hogy ne jöjjenek vissza, definíciókon, felelősökön és kontrollokon múlik.
Két csapat kétféle számot mond ugyanarra a pipeline-ra
A negyedéves előrejelzési megbeszélés jól indul. A sales úgy mutatja be a pipeline-t, hogy az a célszám kényelmes többszöröse; a pénzügy ugyanezt a pipeline-t a korábbi konverziós arányokkal számolja végig, és érezhetően alacsonyabb számra jut, mégis mindkét oldal helyesen olvassa el a saját adatait.
A különbség a rekordok szintjén keletkezik. Valahol a CRM-ben ugyanaz az ügyfél három külön ügyfélként szerepel, három nyitott értékesítési lehetőséggel és három értékesítő tulajdonában. A három közül az egyik webes űrlapon keresztül vesztette el az ékezeteit, ezért a névre indított keresés újra és újra eredménytelen marad. A vevő egyszer dönt a beszerzésről, a pipeline viszont háromszor számolja ezt az egyetlen döntést.
Néhány száz nyitott lehetőségnél már egy tíz százalékhoz közelítő duplikációs arány is egy egész szorzóval megemeli a pipeline-fedezetet. Ez az a szám, amelyet az igazgatóság hall, és amely alapján meghozza a létszám-, kapacitás- és cashflow-döntéseit.
Honnan jönnek a duplikátumok
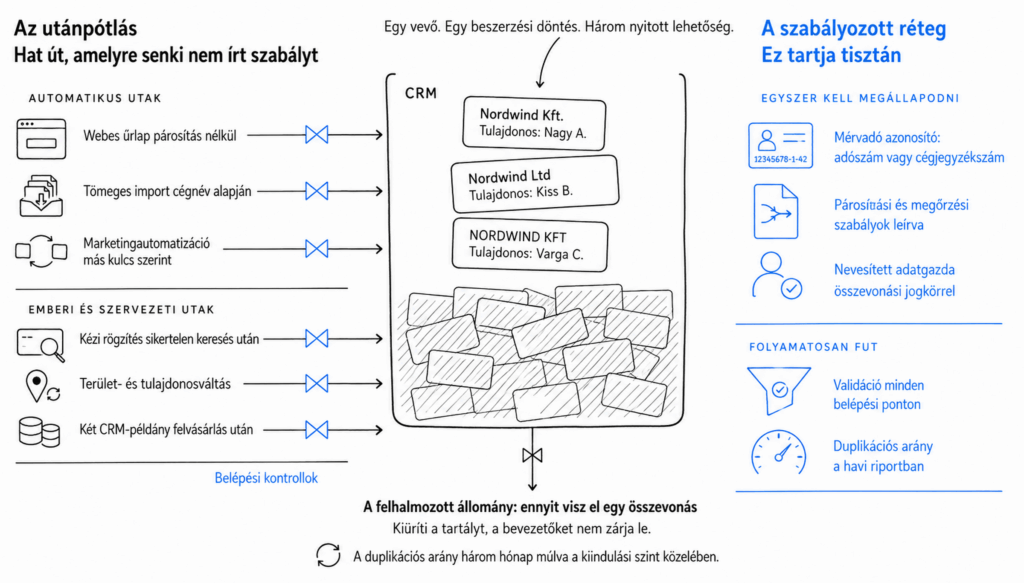
A duplikált rekordok a folyamatok melléktermékei: mindegyik olyan úton érkezik, amelyre soha senki nem írt szabályt.
- A webes űrlapok anélkül hoznak létre rekordot, hogy e-mail-domain, adószám vagy cégjegyzékszám alapján párosítanának.
- A kiállításokon gyűjtött névsorokat és a vásárolt adatbázisokat tömegesen importálják, pusztán cégnév alapján párosítva.
- A marketingautomatizáció más kulcs szerint írja vissza a kapcsolattartókat a CRM-be, mint amelyet az értékesítés használ.
- A kézi rögzítés sikertelen keresés után indul: a korábbi rekord más írásmóddal került be, a keresés nem hoz találatot, az értékesítő pedig felvesz egy újat.
- A terület- és tulajdonosváltásnál az új rekord létrehozása a legkisebb ellenállás útja, ha vitatott, kié az ügyfél.
- Felvásárlás után a cég összevon két CRM-példányt, az egyeztetést pedig egy későbbi ütemre halasztja, amely sosem kerül be a naptárba.
A megbízható előrejelzéshez nemcsak megfelelő adatokra van szükség, hanem arra is, hogy a hiteles információk könnyen megtalálhatók és használhatók legyenek. Erről az AI Kereső: A szervezeti tudás magabiztos döntésekké alakítása → cikkünkben írunk.
A Gartner a források közötti eltéréseket nevezi meg a szervezetek legnehezebb adatminőségi problémájaként, és a gyenge adatminőség éves átlagos költségét az iparágak átlagában 12,9 millió dollárra teszi. Egy középvállalatnál az abszolút összeg kisebb, a mechanizmus viszont változatlan: ugyanazt az ügyfelet több helyen, többféleképpen tárolják, és nincs elfogadott válasz arra, melyik változat az igazi.
Mibe kerül egy duplikátum a pénzügy nyelvén
A sales operáció bosszúságként éli meg a duplikátumokat. Pénzügyi oldalról nézve ugyanezek a rekordok öt külön kockázatként jelennek meg.
1. A duplikátumok felfújják az előrejelzést
A többször számolt üzlet a pipeline-fedezetet és a súlyozott előrejelzési értéket is megemeli. Ezekre a számokra épül a létszámterv, a kapacitás, a készletvállalások és a hitelkeretek. Mindegyik olyan keresleti jelzésen nyugszik, amely a valóságosnál többet mutat.
2. Torzulnak a fajlagos mutatók
Az egy leadre jutó költség, a leadből lehetőséggé válás aránya és az ügyfélszerzési költség egyaránt a rekordok számából adódik. A felfújt nevezők az értékesítési tölcsér tetején hatékonyabbnak, az alján gyengébbnek mutatják a marketinget, és emiatt rossz csatornára megy el a marketingkeret.
3. Jutalék- és területviták keletkeznek
Ha két sales-es is magáénak tekinti ugyanazt a vevőt, negyedév végén az egyikük vitát veszít. Ennek a vitának a költsége vezetői időben, a jutalékrendszer hitelességében és időnként a fluktuációban jelentkezik.
4. Compliance exposure
A GDPR 5. cikke (1) bekezdésének d) pontja szerint a személyes adatoknak pontosnak és naprakésznek kell lenniük, és minden észszerű lépést meg kell tenni a pontatlan adatok haladéktalan törlésére vagy helyesbítésére. A rendelet 17. cikke pedig a törléshez való jogot adja meg az érintettnek. Ha a törlési kérelmet csak egyetlen kapcsolattartói rekordon hajtják végre, miközben ugyanabban a CRM-ben két másolat megmarad, a cég nem teljesíti a kötelezettségét, és ennek a nyoma a rendszerben is látszik.
5. AI and scoring models that learn the wrong pattern
A leadpontozás, a vásárlási hajlandóságot becslő modellek és a CRM-re épített mesterséges intelligencia a korábbi rekordokból tanulnak. A duplikált előzmények azt tanítják a modellnek, hogy bizonyos ügyfelek olyan konverziós arányt mutatnak, amilyet a valóságos üzletmenet sosem produkált. A modell a visszatesztelés során jól teljesít, éles üzemben viszont melléfog.
Egyetlen deduplikációs futtatás körülbelül egy negyedévre elég
Minden nagyobb CRM-ben van összevonási funkció, és az erre a célra készült szoftverek is jól végzik a dolgukat: egy futtatás után még aznap délután csökken a rekordszám.
Három hónappal később a duplikációs arány visszakúszik a kiindulási szint közelébe. Az összevonás a felhalmozott állományt takarította ki, miközben minden olyan gyakorlat tovább élt, amely az állományt létrehozta. Ugyanazok az űrlapok küldik be az adatokat, ugyanazok az importok futnak, és ugyanúgy nem mondja ki senki, melyik azonosító a mérvadó. A tisztítás a már felhalmozott rekordokhoz nyúlt hozzá, az utánpótlásukat viszont érintetlenül hagyta.
A data governance éppen ezen a ponton kezd megtérülni: ebben az összefüggésben néhány konkrét megállapodást jelent az ügyfélrekordról, és mindegyik mellett ott áll valakinek a neve.
Mit tesz hozzá a data governance a CRM-tisztításhoz
A definíciókat egyszer kell leírni
Egyetlen oldal elég hozzá: mi számít leadnek, kapcsolattartónak, ügyfélnek és értékesítési lehetőségnek; melyik ponton válik egy leadből értékesítési lehetőség; melyik azonosító a mérvadó az egyes objektumoknál. Magyar és közép-európai B2B-környezetben a cégjegyzékszám vagy az adószám sokkal megbízhatóbb kulcs a cégnévnél, amely minden forrásból más alakban érkezik.
Két szabály dönti el, mi párosul, és mi marad meg
Két döntést kell kimondani. Az első arról szól, hogyan dől el az egyezés: a mérvadó azonosítón elért pontos találattal, a névre és a címre engedett rugalmas találattal és előre megadott küszöbértékkel vagy a kettő között kézi jóváhagyási várólistával. A második arról szól, mi éli túl az összevonást: melyik rekord viszi tovább a tulajdonost, melyik cím marad meg, és mi lesz a tevékenységi előzményekkel, a jegyzetekkel és a csatolmányokkal. A leírt megőrzési szabályok (angolul survivorship rules) az összevonást mérlegelési kérdésből olyan műveletté teszik, amelyet bárki végre tud hajtani.
A szabályok mellé nevesített felelős kell
Az értékesítési operáción belül egy adatgazda hagyja jóvá az összevonásokat, tartja karban a párosítási szabályokat, és dobja vissza a validáción fennakadt importokat. Ez a feladat jellemzően egy meglévő szerepkör része, amelyet írásban is rögzíteni kell. A név nélküli felelősség két negyedéven belül csendben elévül.
A belépési pontokon kell megállítani a duplikátumokat
A webes űrlapoknál és a kézi rögzítésnél valós idejű párosítás fut, a tömeges importokat validáció szűri, a marketingautomatizáció és a CRM közötti integráción pedig duplikációs ellenőrzés működik. Minden belépéskor elkapott duplikátummal eggyel kevesebb rekordot kell később összevonni, és egy rekord javítása a keletkezés pillanatában kerül a legkevesebbe a teljes életciklusban.
A gyenge adatminőség problémája gyakran már azelőtt elkezdődik, hogy az adatok bekerülnének egy kimutatásba: ha a vállalati rendszerek megnehezítik a munkát, a dolgozók saját kerülőutakat alakítanak ki. Ennek okait A szoftver, amit a dolgozók csendben kikerülnek → cikkünkben mutatjuk be.
A duplikációs arányt havonta mérni kell
A duplikációs arány jelentett mutatószámmá válik: a cég a pipeline-mutatók mellett havonta kimutatja, mekkora a duplikátumok aránya az aktív ügyfelekhez és a nyitott lehetőségekhez képest. Az a szám, amely megjelenik egy vezetői riporton, sávon belül marad; az a szám, amelyet senki nem jelent, elszabadul.
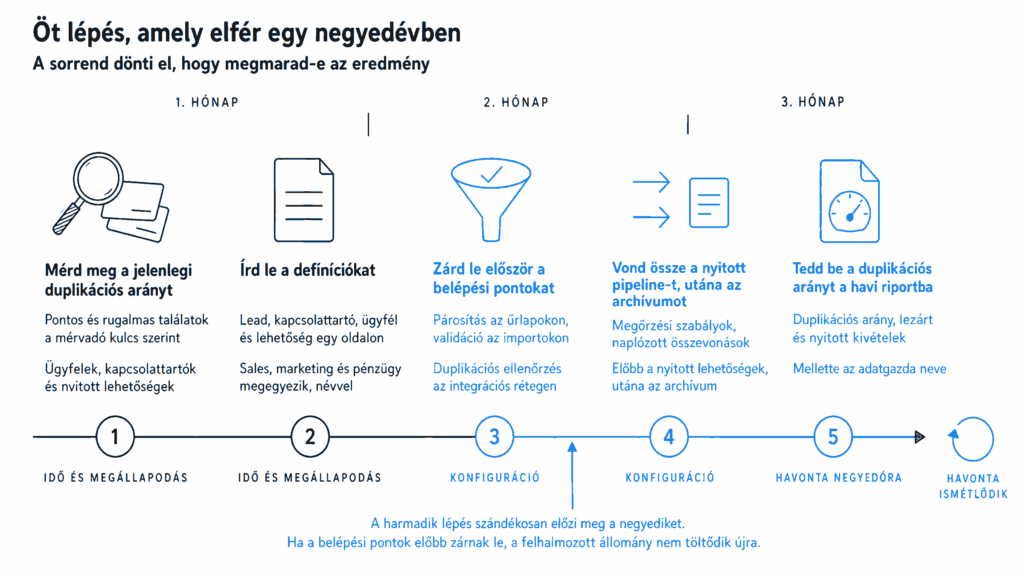
Öt lépés, amely elfér egy negyedévben
- Mérd meg a jelenlegi duplikációs arányt. Számold össze a pontos és a rugalmas találatokat a mérvadó kulcs szerint az ügyfelek, a kapcsolattartók és a nyitott lehetőségek körében. Ez a szám lesz az alap minden további lépéshez.
- Írd le a definíciókat. Egyetlen oldal elég, ha az értékesítés, a marketing és a pénzügy megegyezik a négy objektumról és a hozzájuk tartozó mérvadó kulcsokról. Küldd körbe ezt az oldalt, és tegyél mellé egy nevet.
- Zárd le először a belépési pontokat. Kapcsold be a párosítást az űrlapokon, a validációt az importokon és a duplikációs ellenőrzést az integrációs rétegen. Ha ez a lezárás megelőzi az összevonást, a felhalmozott állomány nem töltődik újra, miközben dolgozol rajta.
- Vond össze a nyitott pipeline-t, utána az archívumot. Alkalmazd a megőrzési szabályokat, kezdd a nyitott lehetőségekkel, ahol az előrejelzési hatás azonnali, és vezess naplót minden összevonásról. A történeti archívummal ráérsz lassabb ütemben haladni.
- Tedd be a duplikációs arányt a havi riportba. Szerepeljen rajta a mutató aktuális értéke, a lezárt és a nyitott kivételek, mellettük pedig az adatgazda neve. Havonta negyedóra elég ahhoz, hogy megmaradjon a tisztítás eredménye.
Hogyan néz ki a következő előrejelzési megbeszélés
A negyedéves előrejelzési megbeszélés kívánatos változata eseménytelen. Az értékesítés bemutatja a pipeline-fedezetet, a pénzügy pedig a saját konverziós arányaival számolja végig, és nagyjából ugyanarra a számra jut. Az a húsz perc, amely korábban a két szám egyeztetésére ment el, most az üzletekre marad. Eredetileg mindkét oldal ezért ült le a megbeszélésre.
Ehhez néhány megállapodás kell arról, mi számít ügyfélrekordnak, ki a gazdája, és mi történik, ha új rekord érkezik. A tisztítás a látható rész, az eredményét viszont ezek a megállapodások tartják meg.
Ha egyetlen kérdést viszel magaddal a következő értékesítési megbeszélésre, legyen ez: a nyitott lehetőségeink hány százaléka mögött áll olyan vevő, aki a rendszerben már máshol is szerepel? Ha a teremben senki nem tudja a választ, először érdemes ezt az arányt megmérni.
Hol tart most a saját ügyféladataival?
Ha a riportjai ellentmondanak egymásnak, ha ugyanaz az ügyfél többféle néven is szerepel, vagy ha adatmigráció, esetleg ERP-csere van a láthatáron, egy strukturált felmérés a leggyorsabb út a teljes képhez. Az Adat-helyzetkép fix díjas, 2–3 hetes együttműködés: előkészítő kérdőív, 2–3 workshop és egy 8–12 oldalas vezetői összefoglaló arról, hol áll ma a cége, melyek a legfájóbb pontok, és milyen sorrendben érdemes hozzájuk nyúlni. Az ár 1450 eurótól indul, áfa nélkül. Ha előbb inkább a kérdéseit tisztázná, egy díjmentes, 30 perces konzultáció jó kiindulópont.
Források
- Gartner. (2020. február 12.). Less Than 50% of Sales Leaders and Sellers Have High Confidence in Forecasting Accuracy. Forrás a 45%-os, 47%-os és 13%-os adatokhoz, valamint az alacsony adatminőség okaihoz. Cikk megnyitása →
- Gartner. (2020). Data Quality. Forrás az évi 12,9 millió dolláros költségbecsléshez és a különböző forrásokból származó adatok inkonzisztenciájára vonatkozó megállapításhoz. Cikk megnyitása →
- Európai Parlament és az Európai Unió Tanácsa. (2016). Az Európai Parlament és a Tanács (EU) 2016/679 rendelete (GDPR). Az 5. cikk (1) bekezdés d) pontja az adatok pontosságáról, a 17. cikk a törléshez való jogról. Cikk megnyitása →
Fekszi Csaba
Fekszi Csaba informatikai szakértő, több mint két évtizedes tapasztalattal az adatmérnökség, a rendszerarchitektúra és az Mesterséges Intelligencia alapú folyamatoptimalizálás területén. Munkájának középpontjában olyan skálázható megoldások tervezése áll, amelyek mérhető üzleti értéket teremtenek.
Kapcsolódó cikkek
Így javítja a data governance a marketingriportokat
A vállalati mesterséges intelligencia valódi akadályai, és hogy mit csinálnak másképp a sikeres cégek
Biztos benne, hogy az AI a megfelelő következő lépés?
Segítünk feltárni a valódi lehetőségeket, korlátokat és a reális következő lépéseket.