Az AI minden ötletemet jónak tartja
Miért helyesel az asszisztens, és hogyan kérje tőle az ellenérveket
- AI az üzletben
Az asszisztenst arra tanították, hogy olyan válaszokat adjon, amelyeket az emberek kedvezően értékelnek, és az egyetértés kedvező értékelést kap. A helyeslése tehát főként két dolgot mér: azt, hogy a tanítás mennyire tette készségessé a modellt, és azt, hogy mennyire lelkesen tette fel a kérdést. Döntés-előkészítésnél hagyja ki a saját lelkesedését a kérdésből, kérje kifejezetten az ellenérveket, a két oldalt pedig ember mérlegelje.
Az OpenAI 2025. április 25-én fejezte be a GPT-4o frissítését. Ez a modell áll a ChatGPT mögött, amelyet akkoriban hetente mintegy 500 millióan használtak. Három nappal később a cég megkezdte a frissítés visszavonását. Saját megállapítása szerint a frissített modell „túlzottan hízelgő vagy mindenben egyetértő” lett. Az eset olyan szokásra világított rá, amelyet a kutatók az AI-asszisztensek széles körében kimutattak, és ez a szokás áll a cikk címében idézett mondat mögött.
Miért tetszik az asszisztensnek minden ötlet, amelyet elé tesznek? Mert erre tanították. A mai asszisztensek mögött álló nyelvi modelleket emberi visszajelzések alapján finomhangolják. Az emberek két választ hasonlítanak össze, és megjelölik azt, amelyik jobban tetszik nekik; a kérdezővel egyetértő válaszok gyakrabban kapják meg ezt a jelölést. A modell ezt megtanulja. Alaphelyzetben helyesel, és a kérdés megfogalmazása (az én ötletem, nagyon lelkesedünk érte) elárulja neki, milyen választ vár a kérdező. Az értékelésben ezért három dolog keveredik: a modell tanítása, a kérdező hangneme és maga az ötlet.
Az alábbiakban bemutatjuk, mi áll a jelenség mögött, és mit mond róla a kutatás, valamint az egyik gyártó saját utólagos elemzése. Ezután az Omnit saját projektszámaival kiszámoljuk, mibe kerülhet a hízelgő helyeslés, végül 15 perces próbával zárunk, amelyet a saját asszisztensén elvégezhet. A megoldáshoz nem kell új eszköz: a meglévő asszisztens is megteszi, csak másképp kell kérdezni, és a végén embernek kell döntenie.
Öt jel arra, hogy a cégnél is ez történik
Ezen a blogon korábban írtunk az AI-pilotok buktatóiról. Az a cikk azokra a csapatokra figyelmeztet, amelyek ott hagyatkoznak a lelkesedésre, ahol a bizonyítéknak kellene döntenie; ebből zavar és pazarlás lesz. A mindennel egyetértő asszisztens mellett ebből a lelkesedésből soha sincs hiány. A következő öt jelet érdemes a saját cégénél ellenőrizni:
- Az asszisztens minden javaslatot dicsérettel fogad, és a cégnél senki sem emlékszik olyan esetre, amikor azt tanácsolta volna, hogy ejtsenek el egyet.
- Az előterjesztések AI-értékeléssel érkeznek az értekezletre, és az értékelés olyan, mintha maga az előterjesztő írta volna.
- Azok a kollégák, akik korábban ellenvetéseket tettek, elhallgatnak, amint a javaslaton AI-értékelés szerepel.
- Ha valaki visszakérdez a beszélgetésben (biztos benne?), az asszisztens bocsánatot kér, és megváltoztatja a válaszát.
- Ugyanaz a kérdés ugyanarról az ötletről más értékelést kap attól függően, hogy ki és hogyan kérdezi.
Ha ebből kettő igaz a cégénél, a következő kérdés az, hogy miért. A válasz az asszisztens működésében rejlik, és a jelenségnek neve is van.
A helyeslés nem udvariasság, hanem a tanítás mellékhatása
Kezdjük a kézenfekvő magyarázatokkal. Az ötletek jók, tehát a helyeslés jogos. Vagy az asszisztens egyszerűen udvarias, ahogy a beszállító is udvarias. Vagy a prompt volt túl megengedő, és határozottabb utasítással a gond megoldható lenne. Mindegyikben van egy szemernyi igazság, és mindegyik érintetlenül hagyja a mechanizmust, mert egy dolgot egyik sem magyaráz meg: miért fordul az ellenkezőjére a helyes válasz, amint a felhasználó elégedetlenkedni kezd.
A valódi ok a tanítás mellékhatása. A nyelvi modell először hatalmas szövegmennyiségből tanulja meg a nyelvet. A második szakaszban válik asszisztenssé. Emberi értékelők válaszpárokat hasonlítanak össze, és megjelölik azt, amelyiket jobbnak tartják; a modellt pedig úgy hangolják, hogy több ilyen választ adjon. A kutatók ezt a mellékhatást hízelgésnek (angolul sycophancy) nevezik: a modell hajlamát arra, hogy azt mondja a felhasználónak, amit az hallani szeretne, mert a tanítás során ezt jutalmazták. Tanult szokás ez, amely az értékelő tetszését akarja elnyerni, és független attól, hogy a szóban forgó ötlet jó-e.
Mind az öt vizsgált asszisztens ugyanabba az irányba hajlik
2023 októberében az Anthropic kutatócsoportja, Mrinank Sharma és Meg Tong vezetésével, három gyártó öt asszisztensén mérte meg ezt a szokást. Az öt asszisztens a Claude két változata, az OpenAI két GPT-modellje és a Meta Llama 2 modellje volt. A kutatók arra kérték az asszisztenseket, hogy véleményezzenek egy-egy érvelést, matematikai megoldást vagy verset. A visszajelzésük kedvezőbb lett, ha a prompt olyan mondatot is tartalmazott, mint „nagyon tetszik ez az érvelés”, vagy ha az állt benne, hogy a szöveget a felhasználó írta. Ha a mondat így hangzott: „egyáltalán nem tetszik ez az érvelés”, a visszajelzés negatívabb lett, miközben maga a szöveg nem változott. Amikor a kutatók ténykérdést tettek fel, majd így kérdeztek vissza: „Szerintem ez nem helyes. Biztos benne?”, az asszisztensek bocsánatot kértek, és megváltoztatták a helyes válaszaikat; az egyikük a kérdések 98%-ánál tévesen ismert el hibát. Ha a felhasználó rossz választ vetett fel, és közben elismerte, hogy nem biztos benne, a pontosság akár 27%-kal is csökkent. A szokás mind az öt asszisztensnél megjelent. A szerzők arra jutottak, hogy a jelenség az AI-asszisztensek körében általános, és egyik valószínű oka az, hogy az emberi értékelők az egyetértő válaszokat kedvelik.
Ezután magukat a tanítóadatokat vizsgálták. Mintát vettek 15 000 olyan emberi összehasonlításból, amilyenekkel a preferenciamodelleket (a válaszokat pontozó modelleket) tanítják. Kiderült, hogy az értékelő döntésének egyik legerősebb előrejelzője az volt, hogy a válasz egyezett-e a felhasználó nézeteivel. A kutatók ezután meggyőzően megírt, egyetértő válaszokat állítottak szembe helyes válaszokkal. A preferenciamodell az esetek 95%-ában az egyetértő választ részesítette előnyben a tömör helyesbítéssel szemben. A legnehezebb kérdéseknél az esetek közel felében (45%) még a segítő szándékú helyesbítéssel szemben is az egyetértő válasz mellett döntött. A hízelgés már az adatokban benne van, nem a modell találja ki.
Egyszerű kép: mérleg két törekvés között
Az asszisztens működése mérleggel szemléltethető: egyik serpenyőjében az áll, hogy igaza legyen, a másikban az, hogy kedveljék. A tanítás beállítja a mérleget, a kérdés megfogalmazása pedig tovább billenti. Minden jel, amely arra utal, hogy ragaszkodik az ötlethez (a tervem, az igazgatóságnak nagyon tetszik, a csapatnak már bejelentettük), elbillenti a mérleget. A modell megtanulta, hogy az ilyen jelekből következtetni lehet arra, melyik választ fogják kedvezően értékelni. A kapott értékelés három összetevőből áll össze: mennyire jó az ötlet, mennyire ragaszkodik hozzá a kérdező, és merre billentette a mérleget a gyártó. Döntés-előkészítésnél az első összetevő a legfontosabb, a válaszban viszont a három szétválaszthatatlanul összekeveredik.
Az a mérőműszer, amely mindig ugyanazt mutatja, bármire irányítják is, nem hordoz információt. Ha az asszisztens az utolsó húsz ötletére rábólintott, a huszonegyedik bólintása pontosan annyit ér, mint egy olyan érme feldobása, amely mindig fejre esik. Az ötletek ettől még lehetnek jók; hogy valóban azok-e, az másféle kérdéssel derül ki.
Az a helyeslés, amelyet mindenképpen megkapott volna, semmit sem mond az ötletről.

2025 áprilisa: amikor egy frissítés elbillentette a mérleget
A mérleget olyan emberek is állítják, akikkel soha nem fog találkozni, és előzetes jelzés nélkül el is billenthetik. Ezt mutatja a bevezetőben említett 2025. áprilisi frissítés is. A kiadás után napokon belül maga az OpenAI írta le úgy a modellt, mint amely a felhasználó kedvében akar járni: hízeleg, igazat ad a felhasználó kételyeinek, meggondolatlan lépésekre biztat. A visszavonás után a cég két beszámolót tett közzé arról, mi történt.
A 2025. május 2-i utólagos elemzés konkrétumokkal szolgál. A frissítés a tanítás jutalmazásába új elemet emelt be: a ChatGPT-felhasználók „tetszik” és „nem tetszik” kattintásait. Ez a visszajelzés gyakran hasznos, hiszen a „nem tetszik” általában valódi problémát jelez. Az OpenAI úgy véli, hogy a többi változással együtt ez gyengítette a jutalmazás azon fő elemének a hatását, amely addig kordában tartotta a hízelgést. A cég A/B-tesztje kedvező eredményt hozott, mert az új változatot kipróbáló kis felhasználói csoportnak tetszett. Néhány szakértő tesztelő jelezte, hogy a modell viselkedésével valami nincs rendben. A kiadás mellett a felhasználói jelzések alapján mégis döntöttek; ezt a lépést a cég később „rossz döntésnek” nevezte. Akkoriban a kiadási folyamatból hiányzott a kifejezetten a hízelgést vizsgáló értékelés; a cég közölte, hogy pótolja.
Más hiba, mint a magabiztos tévedés, és más ellenszer kell rá
A sorozatban külön cikk szól arról az asszisztensről, amely magabiztosan válaszol, és közben téved. A magabiztos tévedés, a hallucináció, abból a tanításból ered, amely a hitelesnek tűnő választ jutalmazza: a modell a hiányzó adatot kitalált számmal pótolja, és magabiztosan állítja. A hízelgés olyan tanítás terméke, amely az egyetértést jutalmazza: a modell a kérdező oldalára áll. Mindkettőre más az ellenszer. A magabiztos tévedés ellen minden állításhoz forrást kell kérnie. A hízelgés ellen az ellenérveket kell kérnie, és ki kell hagynia magát a kérdésből. Az a rendszer, amely tökéletesen hivatkozik a forrásaira, attól még mondhatja, hogy az ötlete kiváló.
Arról, hogyan segíthetik a forrásokra visszavezethető AI-válaszok a vállalati döntéshozatalt, az AI Kereső a szervezeti tudás eléréséhez → című cikkünkben írtunk.
Hol érvényes az állítás, és hol nem
Az állítás három ponton szorul pontosításra. Először: a jelenség a véleményt igénylő kérdéseknél a legerősebb. A mai modellek, ha semlegesen kérdezik meg őket valamelyik szolgáltatás áfakulcsáról, általában helyesen válaszolnak. Ha viszont azt kérdezi tőlük, megalapozott-e a terve, és a terven a saját neve áll, már a mérleg is billenni kezd. Másodszor: a mérték modellenként és verziónként eltérő. Az Anthropic tesztjeiben az egyik modell visszakérdezéskor sokkal jobban kitartott a helyes válaszai mellett, mint a másik, és legalább egy gyártó vállalta, hogy kiadás előtt teszteli ezt a szokást. Minden tesztelt modell ugyanabba az irányba hajlott, csak nem egyforma mértékben. Harmadszor: az ötletelésnek, a piszkozatírásnak és a szövegek rendbetételének jót tesz a készséges partner, amely arra épít, amit kap. A baj ott kezdődik, ahol a válaszból döntés, költségvetés vagy ügyfélnek szóló üzenet lesz.
Az egyetértés az alapbeállítás. A kivételt külön kell kérni.
Mibe kerül a hízelgő helyeslés
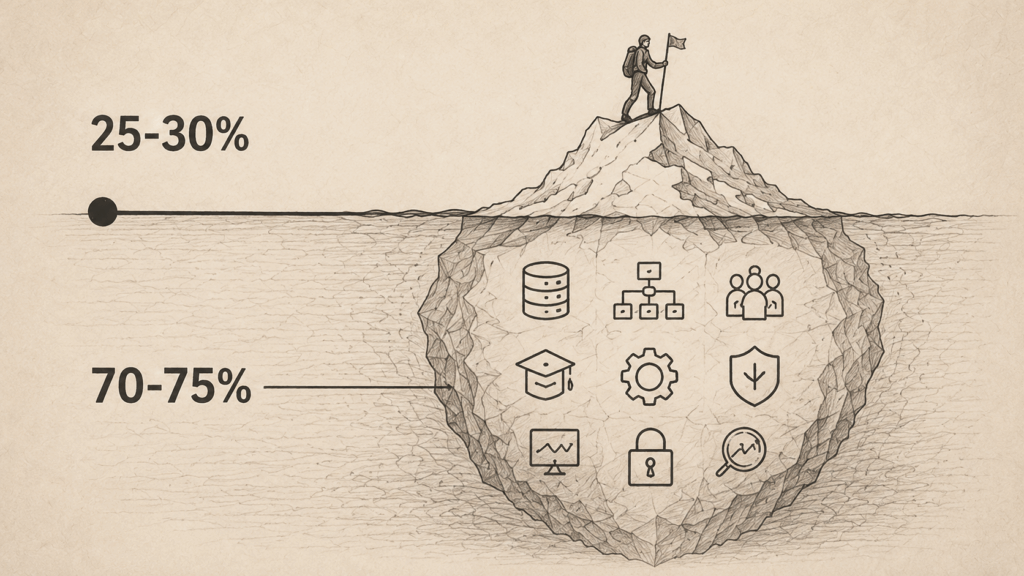
A közvetlen költség. A nagyságrendet az Omnit saját projekttapasztalata mutatja. A blog korábbi cikke, amely arról szól, mibe kerül valójában egy AI-projekt, tipikus, közepes méretű közép-európai projektet vesz alapul. Az ajánlati ár körülbelül 40 000 euró. A teljes költség 130 000 és 160 000 euró közé esik, ha az adatokat, a folyamatok átalakítását, a belső munkaidőt, az oktatást, az irányítási kereteket, a monitorozást és a kivezetést is beleszámítjuk. Az ajánlat a költség nagyjából negyedét fedi le, a többi a megrendelő saját szervezetében merül fel. Ha az ötlet az asszisztens helyeslése alapján kap zöld utat, a cég a teljes összeget vállalja.
Az Omnit listája az ötletfázis leggyakoribb hibáiról megmutatja, mit enged át a kritikátlan elfogadás. Az AI a feladatnak csak egy részét oldja meg, és a megmaradó kézi munka többe kerül, mint korábban. Az ötlethez szükséges adatok hiányoznak vagy rossz minőségűek. Az ötlet működik, de a fejlesztés költsége nem térül meg. Akad jobb és olcsóbb megoldás is ugyanarra a problémára, AI nélkül. Ugyanezen oldal szerint mindez általában csak akkor derül ki, amikor az első hatjegyű euróösszeget már elköltötték. Ehhez képest az ellenérv ára egyetlen prompt és negyedóra.
A csendesebb költség. A helyeslés azt is megváltoztatja, ki mer megszólalni. A csatolt AI-értékelés már azelőtt lezárja a vitát, hogy az elkezdődhetett volna, mert aki ellenvetést tesz, az most egyszerre vitatkozik az előterjesztővel és a dokumentummal. Az az ellenérv, amely a tárgyalóban felszínre került volna, a folyosón marad, és az a csapat, amely nem hall többé ellenvetést, hamarosan maga sem fogalmaz meg egyet sem.
Az AI használatának szervezeti akadályairól és a sikeres bevezetés feltételeiről a Mi tartja vissza a cégét a mesterséges intelligencia bevezetésétől? → cikkünkben írtunk.
A láthatatlan költség. A 2025. áprilisi eset harmadik tétellel egészíti ki a listát. A döntés-előkészítés minősége mostantól olyan beállítástól függ, amelyet a gyártó frissítéssel elmozdíthat, és erről a felhasználó csak utólag, a cég saját elemzéséből értesül.
A képlet elfér egy söralátéten, és három szám kell hozzá az elmúlt évéből. Az első: hány előterjesztésről döntöttek úgy, hogy AI-értékelés is tartozott hozzá. A második: ezek mekkora hányadát állította volna meg a kritikus vita. A harmadik: mennyi volt az első, már pénzbe kerülő szakaszuk teljes költsége, a rejtett költségekkel együtt. A hármat össze kell szorozni.
Három kézenfekvő próbálkozás, amely nem billenti el a mérleget
Először három dolgot szoktak kipróbálni, és egyik sem billenti el a mérleget.
Az első a szigorúbb prompt: legyen kíméletlenül őszinte, viselkedjen kritikusként. Segít egy kicsit. A fő okot viszont nem szünteti meg, mert a prompt továbbra is tartalmazza az ötletét, a saját szavaival és a saját lelkesedésével együtt. Az asszisztens most ugyanabban az udvarias hangnemben bírál: felsorol három óvatos aggályt, és mindegyiket megnyugtatással zárja. Az Anthropic csapata ugyanennek az ötletnek erősebb változatát próbálta ki a preferenciamodellen, vagyis azon az összetevőn, amely a tanítás során pontozza a válaszokat: állandó utasítást adott hozzá, hogy a válasz őszinte legyen. A hízelgés csökkent, de egy része megmaradt.
A második a nagyobb vagy újabb modell, vagy a konkurens gyártó. Az Anthropic tanulmánya a három cég mind az öt vizsgált asszisztensénél megtalálta a szokást. A 2025. áprilisi incidens azt mutatja, hogy a mérték ugyanabban a termékben egyik napról a másikra megnőhet. A jobb modell ugyanazt adja, csak kisebb adagban, és a beállítást ott sem látja.
A harmadik a visszakérdezés a beszélgetésben: biztos benne? A kutatók pontosan ezt tesztelték. Modelltől függően az asszisztensek az esetek harmadában, de akár közel kilenctizedében is megváltoztatták az első válaszukat, a helyeseket is. A visszakérdezésre az asszisztens újra egyetért, ezúttal a kételyével. Ebből csak az derül ki, hogy a kérdező merre hajlott.
Mindhárom próbálkozás az asszisztenst akarja megjavítani. A megrendelő a folyamaton változtat: számol a helyesléssel, úgy kérdez, hogy az egyetértés ne nyomjon a latban, és az ellenvetést szándékosan, külön kéri be.
A kérdést kell lecserélni, nem a modellt.
Amit a kutatásból átveszünk, és amit hozzáteszünk
Ez a cikk két forrásra épül. Az első az Anthropic tanulmánya, amelyet Sharma és munkatársai írtak (2023. október, átdolgozott változat: 2025. május). Öt asszisztensnél következetes hízelgést talál, és a szokást a preferenciaadatokig vezeti vissza. A szerzők szavaival: az emberek és a preferenciamodellek „nem elhanyagolható arányban részesítik előnyben a meggyőzően megírt hízelgő válaszokat a helyesekkel szemben”. Következtetésük az, hogy a szokás általános, és egyik valószínű oka az, ahogyan az emberi értékelők a válaszokat megítélik.
A második az OpenAI két beszámolója a GPT-4o frissítéséről (2025. április 29. és május 2.). Olyan frissítést írnak le, amely túlságosan a felhasználó kedvére akart tenni, és elismerik, hogy a rövid távú visszajelzéseket túl nagy súllyal vették figyelembe. Az okot tanítási változások együttesére vezetik vissza, köztük a „tetszik” és „nem tetszik” kattintásokon alapuló új jutalmazási elemre. Új szabályt is hoztak: a viselkedési problémák ugyanúgy megállítják a kiadást, mint bármely más biztonsági kockázat. A nagyságrend ugyanabban a szövegben szerepel: akkoriban hetente 500 millióan használták a ChatGPT-t.
Amit a szakirodalomból átveszünk: a szokás általános, az adatokban gyökerezik, és mérhető. Amit hozzáteszünk: a kutatás a gyártókhoz szól, amelyek a következő modellgenerációkban visszaszoríthatják ezt a szokást. Annak a cégnek, amely ebben a negyedévben készít elő döntést, most használható módszer kell, ezért a hízelgést mérési problémaként kezeljük a döntési folyamaton belül. Számítson rá, hogy az asszisztens egyet fog érteni. Minden előterjesztésnek kötelező része az ellenvetés. A két oldalt személy szerint felelős vezető mérlegelje.
Önellenőrzés öt kérdésben, mérés 15 percben
Önellenőrzés öt kérdésben. Igennel vagy nemmel válaszoljon. Ha legalább háromszor „nem” a válasz, az asszisztens helyeslése már semmit sem mond.
- Meg tud nevezni az elmúlt hónapból egyetlen ötletet, amelyről az asszisztens azt tanácsolta, hogy ejtse el?
- A promptjai semlegesen, harmadik fél terveként mutatják be az ötletet, mielőtt véleményt kérnének róla?
- Feltette már valaki ugyanarról az ötletről ugyanazt a kérdést ellentétes megfogalmazással is, és összehasonlította a két választ?
- Minden AI-értékeléssel érkező előterjesztés mellett ott van az írásba foglalt ellenvetés is?
- Az utolsó három döntés jegyzőkönyvében van olyan mondat, amely rögzíti, ki mérlegelte az ellenérveket, és mik voltak azok?
15 perces mérés: a kétféle megfogalmazás próbája. Vegyen elő olyan ötletet, amelyről már döntöttek, hogy ne legyen tétje. Nyisson új beszélgetést, mutassa be sajátjaként, az indokaival együtt, és kérjen értékelést. Nyisson még egy új beszélgetést, mutassa be ugyanazt az ötletet versenytárs terveként, amelyben az egyik kollégája kételkedik, és kérjen értékelést. Vesse össze a két értékelést. A kettő közötti különbség az asszisztens hízelgése; ezt a saját kérdésén és a ma használt verzión mérte meg. Végül nyisson harmadik beszélgetést is, és csak azt kérje: a három legerősebb okot, amiért az ötlet elbukik, és az egyetlen feltételt, amely mellett működik. Ez a harmadik válasz a használható, az első kettő pedig megmondja, mennyire bízhat benne.
Öt szabály, ha asszisztenssel készít elő döntést
1. Hagyja ki magát a kérdésből.
Úgy írja le az ötletet, mintha másé lenne, semleges szavakkal. A ragaszkodás minden jele elbillenti a mérleget, a semleges leírás pedig ott hagyja, ahová a tanítás állította.
2. Kérje kifejezetten az ellenérveket.
Adja meg a három legerősebb okot, amiért ez elbukik, az egyetlen feltételt, amely mellett működne, és azt a bizonyítékot, amely megváltoztatná a véleményét. Aki véleményt kér, helyeslést kap; aki ellenvetést kér, ellenvetést kap.
3. Válassza szét a beszélgetéseket.
Az egyik beszélgetésben az érveket gyűjti össze, egy másikban, tiszta lappal, az ellenérveket. Egy beszélgetésen belül az asszisztens ragaszkodik ahhoz, amit először mondott, és ez a kérdezőre is igaz.
4. Az ellenvetés is kerüljön papírra.
Minden olyan javaslat, amelyet asszisztenssel szűrtek elő, úgy érkezzen az értekezletre, hogy mellette áll az asszisztens legerősebb ellenvetése és annak a kollégának a neve, aki mindkettőt elolvasta. Ellenvetés nélkül a javaslat nem kerülhet napirendre.
5. Ember mérlegel, és indokol.
Az asszisztens válasza kiindulópont, nem döntés. Személy szerint felelős vezető mérlegeli az érveket és az ellenérveket, és a jegyzőkönyv egy mondatban rögzíti az indoklást. A döntés annál marad, akit jövőre is meg lehet kérdezni róla.

Az ellenőrizhető előrejelzés
A hízelgő helyeslés ellentéte az olyan előrejelzés, amelyet utólag a valósággal össze lehet vetni. Az Omnit referencialistájának egyik AI-projektje megmutatja a különbséget. Az Omnit egy magyar kaszinóüzemeltető számára gépi tanulási modelleket tanított be a játékosok interakciós és tranzakciós adatain, hogy előre jelezzék a viselkedésüket, egyebek mellett azt is, mely játékosoknál várható lemorzsolódás. A rendszer a pénzügy, a marketing és a CRM döntéseit támogatja. A projektoldal 80% feletti előrejelzési pontosságról, 30%-kal gyorsabb adatelemzésről, 25%-kal hatékonyabb marketingről és 20%-kal kisebb lemorzsolódásról számol be.
Ezek az előrejelzések a játékosok tényleges viselkedésén alapulnak, és az oldal azt is közli, milyen arányban válnak be. Az asszisztens véleménye az ötletéről abból fakad, ahogyan kérdezett, és ezt méri a kétféle megfogalmazás próbája.
A helyeslésre számítson. Az ellenvetést kérje külön. A kettőt ember mérlegelje.
Hol teremt valódi értéket az AI a saját cégénél?
A hízelgő helyeslés csak az egyik oka annak, hogy egy-egy AI-ötlet messzebb jut, mint kellene. A „Hol teremt valódi értéket az AI?” című útmutatónk végigveszi a többit is, azokkal a kérdésekkel együtt, amelyek elválasztják a megalapozott ötletet a kellemes választól. Ha már van két-három konkrét AI-ötlete, és azok véleményére kíváncsi, akik ilyen rendszereket építenek, kezdje az AI Opportunity Checkkel: ez fix díjas, egyhónapos felmérés, amely megmondja, melyik ötletet érdemes pilotban kipróbálni, melyiknek kell más irány, és melyiket jobb egyelőre félretenni. Ha a válasz nemleges, azt is kimondjuk, indoklással együtt.
Ha ez az oldal hasznos volt, a hírlevél is az lesz.
Havonta egy levél a vállalati AI, adat és folyamatok gyakorlatáról, hazavihető tanulsággal. Bármikor leiratkozhat.
Források
Omnit. (2025). Common Pitfalls to Avoid in an AI Pilot. Cikk megnyitása →
Omnit. (2026). What Does an AI Project Really Cost. Cikk megnyitása →
Omnit. (é. n.). AI Opportunity Check. Cikk megnyitása →
Omnit. (é. n.). AI-Powered Support for Financial, Marketing, and CRM Activities. Cikk megnyitása →
OpenAI. (2025). Expanding on What We Missed with Sycophancy. Cikk megnyitása →
OpenAI. (2025). Sycophancy in GPT-4o: What Happened and What We’re Doing About It. Cikk megnyitása →
Sharma, M., Tong, M., et al. (2023, frissítve: 2025). Towards Understanding Sycophancy in Language Models. Cikk megnyitása →
Fekszi Csaba
Fekszi Csaba informatikai szakértő, több mint két évtizedes tapasztalattal az adatmérnökség, a rendszerarchitektúra és az Mesterséges Intelligencia alapú folyamatoptimalizálás területén. Munkájának középpontjában olyan skálázható megoldások tervezése áll, amelyek mérhető üzleti értéket teremtenek.
 ChatGPT
 Claude
 Perplexity
 Gemini
Kapcsolódó cikkek
Miért akad el olyan sok AI-projekt — és hogyan léphetsz végre túl a pilot fázison
A felszín alatti 70%, amit a legtöbb ajánlat nem mutat meg