GDPR és data lineage
Így lesz a megfelelésből rutinfeladat
- AI az üzletben
Egy közepes méretű vállalatnál a megfelelőségi munka jelentős része azzal telik, hogy megtalálják, hol vannak a személyes adatok. Az adatútvonalak feltérképezésével a hosszas keresgélés egyszerű visszakereséssé válik.
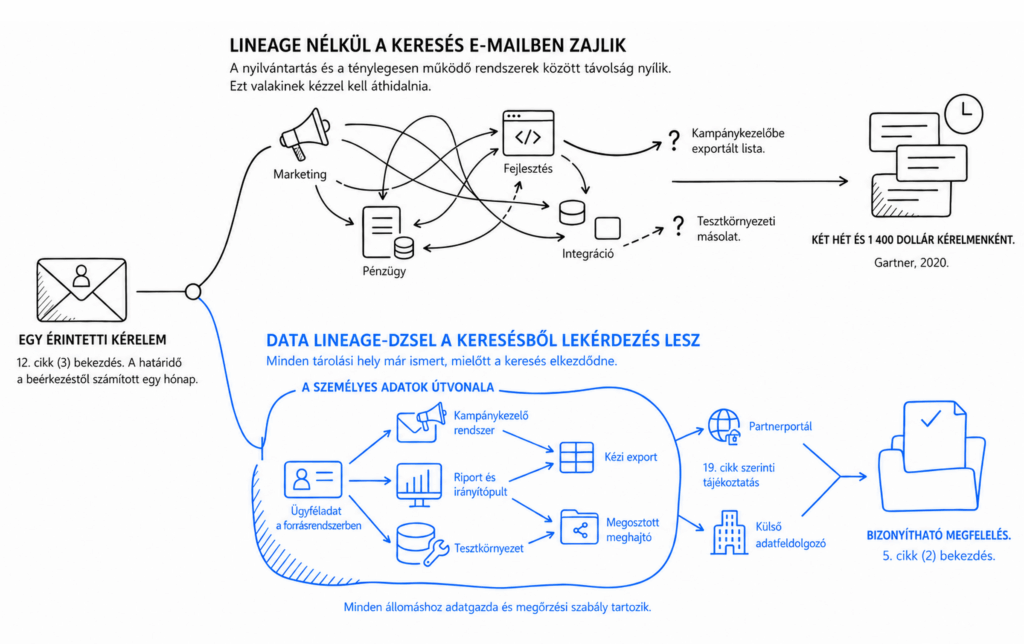
A szervezetek kétharmadának legalább két hétbe telik, mire megválaszol egyetlen érintetti kérelmet, és egy kézzel feldolgozott kérelem átlagosan 1400 dollárba kerül. Ezeket a számokat a Gartner tette közzé 2020-ban, a 2019-es Security and Risk Survey alapján. Azóta megnőtt a kérelmek száma, és megszaporodtak azok a rendszerek is, amelyekben személyes adatokat tárolnak.
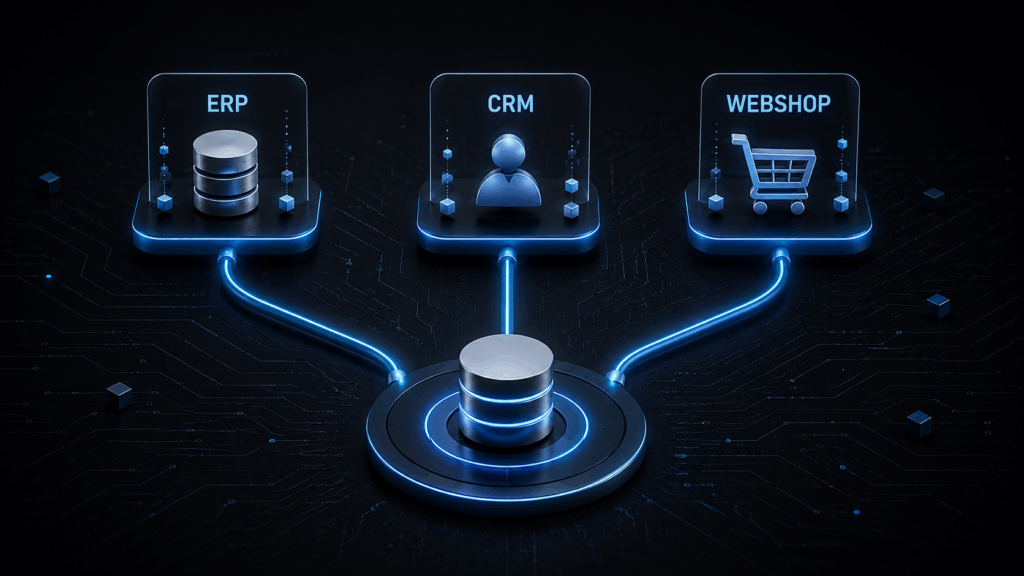
Egy olyan cégnél, ahol ERP, CRM, bérszámfejtő rendszer, webshop és néhány Excel-export működik egymás mellett, a GDPR nehézsége egyetlen kérdésbe sűrűsödik: hol tárolják egy adott ügyfél adatait, és merre jártak eddig? A megfelelés minden további lépése ebből a kérdésből következik.
Mit kell bizonyítanod a rendelet szerint
A GDPR az elszámoltathatóságra épül. Az 5. cikk (2) bekezdése az adatkezelőt teszi felelőssé azért, hogy a megfelelést bizonyítani is tudja, és több kötelezettség is ezt az elvet bontja le kézzelfogható bizonyítási feladatokra.
- A 30. cikk írásos nyilvántartást ír elő az adatkezelési tevékenységekről. Ebben szerepelnie kell a céloknak, az érintettek és a személyes adatok kategóriáinak, a címzetteknek, a harmadik országba irányuló továbbításoknak és a tervezett törlési határidőknek.
- A 15. cikk alapján az érintett megtudhatja, milyen kategóriájú személyes adatot kezelsz róla, kik kapják meg, és meddig tervezed megőrizni.
- A 17. cikk biztosítja a törléshez való jogot, az 5. cikk (1) bekezdésének e) pontja pedig a tárolást a célhoz szükséges időtartamra korlátozza.
- A 19. cikk szerint minden helyesbítésről, törlésről és az adatkezelés korlátozásáról tájékoztatnod kell mindazokat a címzetteket, akikkel a személyes adatot közölted.
- A 12. cikk (3) bekezdése a kérelem beérkezésétől számított egy hónapban húzza meg a válaszadás határidejét. Ez a határidő összetett vagy nagy számú kérelem esetén további két hónappal meghosszabbítható.
Ezek a cikkek együtt egyetlen tervrajzot írnak le. A felügyeleti hatóság arra kíváncsi, hol kerül be a személyes adat a céghez, milyen rendszereken halad át, ki kap belőle másolatot, és mikor törlik az egyes példányokat.
Miért nehéz megrajzolni ezt a tervrajzot
A legtöbb középvállalatnál van 30. cikk szerinti nyilvántartás. Ez rendszerint egy táblázat, amely egyetlen megfelelési projekt során állt össze, és úgy írja le a rendszereket, ahogyan azok a táblázat megszületésének napján működtek.
A cég működése közben ez a kép folyamatosan változik. Egy marketinges kollégád ügyféllistát exportál a kampánykezelő rendszerbe, a pénzügy irányítópultot épít az éjszakai kigyűjtésre, a fejlesztő átmásolja az éles adatbázist tesztkörnyezetbe, egy integráció pedig kapcsolattartói adatokat továbbít a partnerportálra. Mindegyik lépés jogos üzleti indokból történik, és mindegyik új helyet teremt a személyes adatnak. Ezekről az új helyekről a táblázatnak esélye sincs tudomást szerezni.
A személyes adatok ritkán találhatók meg kizárólag strukturált adatbázisokban. A dokumentumok és az e-mailek ugyanolyan láthatósági és ellenőrzési kihívást jelentenek, de sokkal nagyobb léptékben. Nézze meg, hogyan dolgozhatják fel a szervezetek ezeket az információkat szisztematikusan az Intelligens Dokumentumfeldolgozás (IDP) → segítségével.
A megfelelési kockázat abban a távolságban gyűlik, amely a nyilvántartás és a ténylegesen működő rendszerek között nyílik. Amikor megérkezik egy kérelem, valakinek kézzel, e-mailben, szűk határidővel kell ezt a távolságot áthidalnia.
Mit jelent a data lineage üzleti nyelven
A data lineage az a dokumentált útvonal, amelyen egy adatelem az eredetétől eljut minden helyre, ahol használják. Egy olyan hétköznapi adatnál, mint az ügyfél e-mail-címe, a data lineage négy kérdésre ad választ.
- Hol keletkezett az adat: melyik forrásrendszerben, űrlapon vagy adatimport során?
- Mely rendszerek, riportok vagy fájlok másolják tovább az adatot, és milyen interfészen vagy ütemezett feladaton keresztül?
- Kinek van hozzáférése az adathoz az egyes állomásokon, beleértve a külső adatfeldolgozókat és partnereket is?
- Melyik megőrzési szabály vonatkozik az adott állomáson tárolt példány törlésére, és ki tartatja be ezt a szabályt?
Egy data governance programban a data lineage három másik elem mellett kap helyet. A fogalomtár rögzíti az egyes adatelemek jelentését, a felelősségi modell megnevezi az adatgazdát, a minőségi szabályok pedig meghatározzák, mi számít érvényes értéknek. A data lineage azzal egészíti ki őket, hogy megmutatja, hol találhatók ezek az adatok. A másik három elem ezt eleve adottnak veszi.
Egy példa: egy törlési kérelem útja a beérkezéstől az igazolásig
Az alábbi példa szemléltető jellegű. Egy közepes méretű vállalat tipikus helyzetét mutatja be, és nem tartalmaz konkrét ügyfélprojektből származó adatokat.
Adatútvonalak feltérképezése nélkül
Egy korábbi ügyfél kéri személyes adatainak törlését. Az adatvédelmi tisztviselő e-mailben megkeresi az IT-t, a pénzügyet, a marketinget és az ügyfélszolgálatot. Mind a négy csapat a saját rendszereiben kezdi keresni az adatokat. A marketing megtalálja az ügyfél adatait a kampánykezelő rendszerben, majd kiderül, hogy hat hónappal korábban egy ügynökségnek is továbbítottak egy listát. Azt azonban senki sem tudja biztosan, hogy az ügynökségnél megvan-e még. A riportingcsapat eközben egy példányt talál az adattárházi rétegben, egy másikat pedig a biztonsági mentések között.
Két hét telik el az egyeztetéssel. A vállalat végül visszaigazolja az adatok törlését, de a válasz mögött nincs olyan dokumentáció, amely bizonyítaná, hogy minden példányt megtaláltak és kezeltek. Ha később a hatóság igazolást kér, lényegében egy e-mail-lánc áll rendelkezésre.
Feltérképezett adatútvonalakkal
Ugyanez a kérelem bekerül a kérelmek nyilvántartásába. Az adatútvonal-térkép azonnal megmutat minden helyet, ahol az ügyfél adatai megtalálhatók: a CRM-rekordot, két integrációs táblát, a riportingréteget, a kampánykezelő rendszert, egy archívumot és a biztonsági mentést. Látható az a két külső címzett is, akik korábban exportált adatokat kaptak, valamint az egyes állomásokhoz tartozó megőrzési szabályok.
Az ügyfélszolgálat elindítja a törlési folyamatot, amelynek minden lépése naplózásra kerül. A GDPR 19. cikke szerinti értesítés automatikusan eljut a két címzetthez a folyamatosan karbantartott nyilvántartás alapján. A válasz négy munkanapon belül elkészül, a dokumentációból pedig pontosan látható, mely rendszereket érintette a törlés, ki végezte el az egyes lépéseket és mikor.
A jogi kötelezettség mindkét esetben ugyanaz. A különbség abban van, mennyi idő alatt teljesíthető, és milyen minőségű bizonyíték marad utána.
Mit ér ugyanaz a térkép a megfelelőségen túl
A cégek a hatóság kedvéért kezdenek data lineage-t építeni, aztán kiderül, hogy még négy másik problémájuk is ugyanezt a tervrajzot igényli.
- A megőrzési szabály betartathatóvá válik. A tárolási korlátozás akkor lesz betartatható, ha ismered az összes tárolási helyet. Amíg a másolatok láthatatlanok, addig a megőrzési idő lejárta után is bent maradhat személyes adat a rendszerekben.
- A cég naprakész listát kap arról, kik kaptak személyes adatot. Ugyanezt a nyilvántartást használják az adatfeldolgozói szerződések megkötésekor, a biztonsági felülvizsgálatok során és a szerződések felmondásakor is.
- Az adatvédelmi incidensek kezelése felgyorsul. A 33. cikk szerinti 72 órás bejelentési határidő betartása egyetlen korai kérdésen múlik: milyen adat került ki, mely rendszerekből, és hány embert érint?
- A mesterségesintelligencia-projektek tiszta alapokról indulnak. Még mielőtt bármelyik modell tanítása elkezdődne, a csapat meg tudja mondani, mely bemenetek tartalmaznak személyes adatot, és milyen jogalapon használhatók.
Ugyanez a mintázat a kutatási adatokban is megjelenik. A Precisely és a Drexel University LeBow College of Business 2026-os, State of Data Integrity and AI Readiness című felmérése több mint 500 vezető adatszakembert és elemzőt kérdezett meg. Ahol van adatstratégia és data governance program, ott a szervezetek 71 százaléka jelezte, hogy nagymértékben megbízik a saját adataiban. Ahol ezek hiányoznak, ott ez az arány 50 százalék.
Ha a megbízható információk könnyen megtalálhatók a különböző rendszerekben, a megfelelőség is jóval egyszerűbbé válik. Erről írunk az AI Kereső: A szervezeti tudás magabiztos döntésekké alakítása → cikkünkben.
Négy lépés, amivel előre léphetsz a data lineage-ben
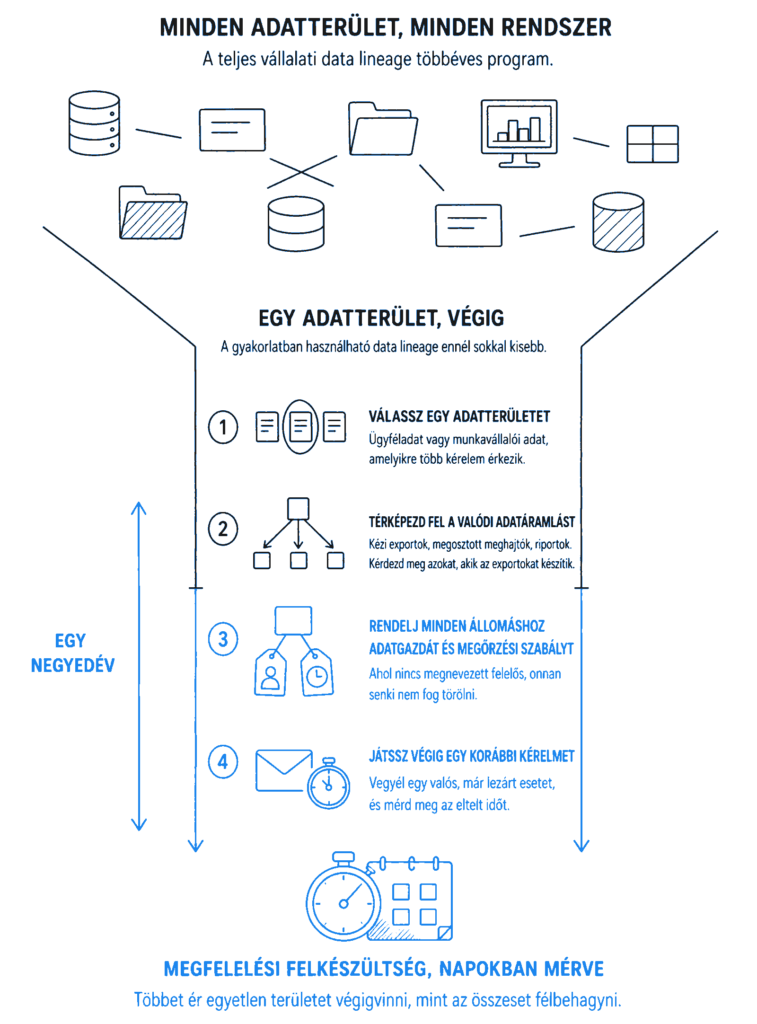
A teljes vállalati data lineage többéves program. A gyakorlatban használható data lineage ennél sokkal kisebb, és egy középvállalat negyedév alatt eljuthat odáig, ha szűkíti a hatókört.
- Válassz egy adatterületet. Az ügyféladat és a munkavállalói adat közül azt vedd, amelyikre több kérelem érkezik. Többet ér egyetlen területet végigvinni, mint az összeset félbehagyni.
- Térképezd fel a valódi adatáramlást. Kövesd az adatot a forrásától minden továbbmásolt példányig, beleértve a kézi exportokat, a megosztott meghajtókat és a riportokat. Kérdezd meg azokat a kollégákat, akik az exportokat készítik, mert az interfészdokumentáció a kézi exportokat ritkán tartalmazza.
- Rendelj minden állomáshoz adatgazdát és megőrzési szabályokat. Ahol nincs megnevezett felelős, onnan senki nem fog törölni.
- Játssz végig egy korábbi kérelmet. Vegyél egy valós, már lezárt esetet, futtasd végig az új térképen, és mérd meg az eltelt időt. Ez a napokban mért szám mutatja a megfelelési felkészültségedet.
Egy perc alatt kiderül, hol tartasz
Egy középvállalatnál a GDPR-megfelelés előbb keresési feladat, és csak utána jogi feladat. A jogszabály 2018 óta változatlanul hatályos, azoknak a helyeknek a száma viszont, ahol ügyféladatot tárolnak, azóta minden évben nőtt. A data lineage a data governance-nek az a része, amely ezt a két tényt egyetlen dokumentumban fogja össze.
A teszt rövid. Vedd elő a legutóbbi érintetti kérelmet, és tegyél fel három kérdést: hány kollégát vont be a megválaszolása, hány napig tartott a folyamat, és ma mivel tudnád bizonyítani, hogy minden példány sorra került. Ha egy percnél tovább tart összeszedni a választ, akkor hiányzik a személyes adatok útvonaláról szóló térkép.
Tudja, hol tárolják a cégénél a személyes adatokat?
Ha a rendszerei gyorsabban szaporodtak, mint a dokumentációja, érdemes azzal kezdenie, hogy strukturáltan átnézi a jelenlegi helyzetet. Az Adat-helyzetkép feltérképezi, hol keletkezik az adat, hol tárolják, és hol szakad meg az információ útja.
2–3 hét | 2–3 workshop | 8–12 oldalas vezetői összefoglaló | 1 450 EUR + áfától
Megkapja a 3–5 legfontosabb problémát, mindegyiknél az üzleti hatással és azzal a sorrenddel, amelyben érdemes hozzájuk nyúlni. Ha 60 napon belül továbblép, a díj 60–90 százaléka beszámítható a következő fázisba, a terjedelemtől függően.
Források
- Európai Parlament és az Európai Unió Tanácsa. (2016). Az Európai Parlament és a Tanács (EU) 2016/679 rendelete (GDPR). A cikkben hivatkozott 5., 12., 15., 17., 19., 30. és 33. cikk forrása. Cikk megnyitása →
- Gartner. (2020. február 25.). Gartner Says Over 40% of Privacy Compliance Technology Will Rely on Artificial Intelligence in the Next Three Years. A kétharmados válaszidő és az érintetti kérelmenkénti 1 400 dolláros átlagköltség forrása. Cikk megnyitása →
- Omnit. (2026). Adat-helyzetkép. A szolgáltatás időtartamának, workshopszámának, terjedelmének, árának és beszámítási feltételeinek forrása. Cikk megnyitása →
- Precisely & Drexel University LeBow College of Business. (2026. január 21.). 2026 State of Data Integrity and AI Readiness. A 71%-os és 50%-os adatbizalmi érték forrása. Cikk megnyitása →
Fehér Lajos
Fehér Lajos informatikai szakértő, közel 30 év tapasztalattal az adatbázis-fejlesztés, különösen az Oracle-alapú rendszerek, valamint az adatmigrációs projektek és a magas rendelkezésre állást, illetve skálázhatóságot igénylő rendszerek tervezése területén. Az elmúlt években munkája mesterséges intelligenciára épülő megoldásokkal is kiegészült, az üzleti szempontból mérhető értéket teremtő rendszerek kialakítására fókuszálva.
Kapcsolódó cikkek

Amit a vállalati döntéshozóknak érteniük kell a skálázás előtt
Gyakorlati útmutató pénzügyi és felső vezetőknek középvállalatoknál
Biztos benne, hogy az AI a megfelelő következő lépés?
Segítünk feltárni a valódi lehetőségeket, korlátokat és a reális következő lépéseket.