Mennyibe kerül az ügyfélszolgálati AI-asszisztens
Tokenárak 2026 végén
- AI az üzletben
Tízezer ügyfélszolgálati beszélgetés tokenköltsége nagyjából 37 dollár.
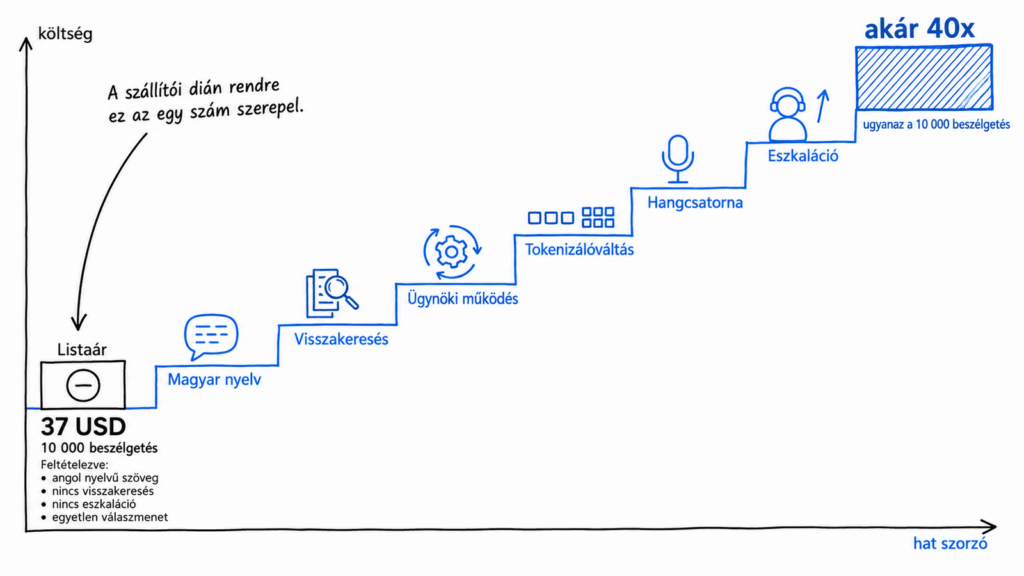
Az adat az Anthropic saját árlistájából származik, és pontosan ez a szám marad le rendre a diáról, amikor az igazgatóság előtt AI-asszisztenst mutatnak be. A 37 dollár olyan kevés, hogy nehéz elhinni, és önmagában félre is vezet: ugyanez a tízezer beszélgetés negyvenszer többe is kerülhet, ha magyarul zajlik, tudásbázisra támaszkodik, és a nehéz eseteket munkatársnak adja tovább. Az alábbiakban bemutatjuk, mennyibe kerülnek a tokenek 2026 szeptemberében, hogyan változnak ezek az árak, és hogyan lehet olyan költségszámítást összeállítani, amely az első számla után is megállja a helyét.
A bérköltséget ismerjük, az AI költségét nem
A szeptemberi budapesti üzleti reggelinken az egyik magyar távközlési cégcsoport üzletágvezetője olyan kérést fogalmazott meg, amely azóta is foglalkoztat. Azt várja, hogy amikor a szállítók olyan ügyfélszolgálati asszisztenst mutatnak be, amely mellett kevesebb emberre van szükség, akkor tegyék mellé az AI-költséget és a tokenfogyasztást is. Vagyis, aki ilyen rendszert kínál, az mutassa meg a mérleg mindkét serpenyőjét.
A kérés jogos, és nehezebb teljesíteni, mint gondolnánk. A bérköltséget könnyű modellezni, hiszen ismert számról van szó, és évente egyszer változik. Az AI-költségnél viszont a listaár évente többször is változik, a fogyasztás alakulását az első pilot előtt senki nem tudja megjósolni, és legalább hat olyan szorzó is számít, amely a szállító árlistájában nem szerepel.
Miből áll össze a tokenszámla
Mindhárom nagy szolgáltató ugyanazt a négy tételt méri: a bemeneti tokeneket, a kimeneti tokeneket, a gyorsítótárazott bemenetet és a gyorsítótárba írást. A különbséget köztük a rájuk rakódó módosító tételek határozzák meg.
A bemeneti tokenek közé tartozik minden, amit a modellnek elküldünk: a rendszerprompt, a hívható eszközök leírása, a visszakeresett dokumentáció és az addigi beszélgetés. A kimeneti tokenek közé pedig minden tartozik, amit a modell ír, még a válasz előtti gondolkodása is. A kimenet a drágább tétel: a mostani modelleknél ötször-hatszor annyiba kerül, mint a bemenet.
A gyorsítótárazott bemenet adja az ügyfélszolgálatban a legnagyobb kedvezményt, hiszen az ügyfélszolgálati asszisztens minden egyes kérésnél ugyanazt a rendszerpromptot és ugyanazt a termékdokumentációt küldi el. A prompt ismétlődő elejét az OpenAI, az Anthropic és a Google egyaránt a normál bemeneti ár 10%-áért számlázza. Az Anthropicnál az ötperces gyorsítótár feltöltése a bemeneti ár 1,25-szorosába kerül, így a gyorsítótárazás már egyetlen újraolvasás után megtérül.
Ehhez jönnek még a módosító tételek. Ha a prompt a szolgáltatónál átlépi a hosszú kontextus határát, külön, magasabb díjszabás alá esik. A Batch API-n keresztül, aszinkron módon feldolgozott feladatokért mindhárom szolgáltató feleannyit számít fel. A szerveroldali eszközök külön tételként jelennek meg: a webes keresés az OpenAI-nál és az Anthropicnál is 10 dollárba kerül 1000 keresésenként. Ráadásul az inferenciát, vagyis a modell tényleges futtatását adott földrajzi régióhoz is lehet kötni; erre a legtöbb magyar nagyvállalatnak szüksége lesz, hogy az adatok helyben maradjanak, és ez mindenhol nagyjából 10%-kal drágítja a szolgáltatást. Az Anthropic 1,1-szeres szorzót alkalmaz a régióhoz kötött inferenciára, a Google 10%-kal többet kér a nem globális végpontokon, az OpenAI pedig 10%-os felárat számol a regionális feldolgozásért a 2026. március 5. óta megjelent modelleknél.
Ennyibe kerülnek a tokenek 2026 szeptemberében
A táblázatban a listaárak szerepelnek amerikai dollárban, egymillió tokenre vetítve, standard díjszabással és rövid kontextussal. A Claude Haiku 4.5 sorában például az 1,00 azt jelenti, hogy egymillió bemeneti token 1,00 dollárba kerül, a 0,10 azt, hogy egymillió gyorsítótárazott bemeneti token 0,10 dollár, az 5,00 pedig egymillió kimeneti token ára dollárban. Az adatokat a szolgáltatók saját árlistaoldalairól vettük át 2026. szeptember 18-án.
| Modell | Bemenet (USD/millió token) | Gyorsítótárazott bemenet (USD/millió token) | Kimenet (USD/millió token) |
|---|---|---|---|
| GPT-5.6 Luna (OpenAI) | 0.20 | 0.02 | 1.20 |
| Gemini 3.1 Flash-Lite (Google) | 0.25 | 0.025 | 1.50 |
| Gemini 3.6 Flash (Google) | 0.75 | 0.075 | 3.75 |
| Claude Haiku 4.5 (Anthropic) | 1.00 | 0.10 | 5.00 |
| Claude Sonnet 5 (Anthropic) | 2.00 | 0.20 | 10.00 |
| Gemini 3.1 Pro (Google) | 2.00 | 0.20 | 12.00 |
| GPT-5.6 Sol (OpenAI) | 4.00 | 0.40 | 20.00 |
| Claude Opus 5 (Anthropic) | 5.00 | 0.50 | 25.00 |
| GPT-6 Astra (OpenAI) | 10.00 | 1.00 | 50.00 |
A legolcsóbb, éles használatra szánt modell és a csúcsmodellek között tehát ötvenszeres a különbség a bemeneti és nagyjából negyvenszeres a kimeneti árban. Ügyfélszolgálati feladatoknál a munka nagy részét az olcsóbb modellek végzik el, hiszen a feladat osztályozásból, visszakeresésből és rövid, pontos válaszokból áll jól körülhatárolt témakörön belül, és ez bőven belefér abba, amit ezek a modellek tudnak.
Mennyibe kerül egyetlen beszélgetés
Az Anthropic pontosan erre a felhasználási esetre közöl mintaszámítást: az átlagos ügyfélszolgálati beszélgetés nagyjából 3700 tokenből áll, ami a Claude Haiku 4.5 modellel 10 000 ügyfélszolgálati jegyenként körülbelül 37 dollárt jelent. Ez beszélgetésenként nagyjából 0,4 amerikai cent. Havi 20 000 beszélgetésnél ez körülbelül 74 dollár, ami bármelyik európai piacon kerekítési hiba egyetlen teljes munkaidős ügyfélszolgálati munkatárs béréhez képest.
Ha a megbeszélés ennyiben marad, az üzleti terv homokra épül. Ez a szám ugyanis angol szöveggel számol, és azt feltételezi, hogy nincs visszakeresés, nincs eszközhívás, nincs eszkaláció, és a modell egyetlen menetben válaszol. Ha ezek közül bármelyik változik, más lesz a végösszeg.
Hat tényezőtől függ, mennyi lesz a valódi költség
- Nyelv. A magyar nyelvet drága tokenizálni. A tokenizálókat többnyire angol szövegen tanítják, ezért a magyar szavak több darabra esnek szét, és ugyanaz a dokumentum jóval több tokent fogyaszt. Ennek hátterét a Why LLMs Are Weaker in Hungarian című, angol nyelvű cikkünkben írtuk le. A költségmodellezés szabálya egyszerű: mérje meg a saját szövegein a tokenszámot, és az angol nyelvű mérési eredményeket tekintse a lehető legkedvezőbb esetnek.
A különbség nemcsak a tokenek számában jelenik meg: ugyanazok a modellek magyarul teljesítményben is jelentősen eltérhetnek az angol nyelvű működéstől. Ennek okait részletesebben bemutatjuk a Miért gyengébbek a nagy nyelvi modellek magyarul? →
- Visszakeresés. A hasznos ügyfélszolgálati asszisztens a cég saját dokumentációjából válaszol, ezért minden válaszhoz több ezer tokennyi visszakeresett kontextus kerül a bemenetbe. Itt térül meg igazán a prompt gyorsítótárazása, hiszen ennek a kontextusnak az állandó részét a normál ár tizedéért számlázzák.
- Gondolkodás és ügynökszerű működés. A Gartner szerint az AI-ügynökök feladatonként 5-ször, de akár 30-szor annyi tokent is elhasználnak, mint amennyit egy hagyományos chatbotkérdés igényel. Az az asszisztens, amely rendelést ellenőriz, szerződést olvas és választ fogalmaz, ügynökként dolgozik, és a költségvetésben is ennek megfelelően kell számolni vele.
- Tokenizálóváltás. Az Anthropic jelzi, hogy a Claude 4.7 és az újabb modellek olyan új tokenizálót használnak, amely ugyanabból a szövegből nagyjából 30%-kal több tokent állít elő. Előfordulhat tehát, hogy a szolgáltató árat csökkent, a havi számla mégis nő; ezért kell ugyanazon a modellen mérni, amelyet aztán éles üzemben is használ.
- Hang. A telefonos asszisztens más árkategóriába tartozik, mint a chatablak. Az OpenAI a valós idejű hangot millió bemeneti tokenenként 32 dollárért, millió kimeneti tokenenként 64 dollárért számlázza; a mini változat 10, illetve 20 dollár, a GPT-Live hangalapú munkamenetek pedig percenként 5 amerikai centbe kerülnek. A Google élő átiratkészítése hangpercenként 0,89 amerikai centnek felel meg. A hangalapú megoldásokhoz tehát külön költségmodell kell.
- Eszkaláció. Minden olyan beszélgetés, amelyet az asszisztens nem tud emberi segítség nélkül lezárni, ugyanúgy elfogyasztja a tokenjeit, és utána még egy ügyfélszolgálati munkatárs idejét is leköti. A lezárási arány, vagyis hogy a beszélgetések mekkora hányadát zárja le az asszisztens önállóan, az egész számítás legfontosabb változója, és éppen ezt a számot egyetlen szállító sem tudja előre megadni.
Az árak változnak, és némelyik csak határidőig érvényes
A fenti táblázat két sorához előre bejelentett záródátum tartozik, egy harmadik, friss árváltozás pedig azt mutatja, milyen gyorsan változhat a többi is.
- A Google 0,75 dolláros bemeneti és 3,75 dolláros kimeneti akciós ára a Gemini 3.6, 3.7 és 3.8 Flash modelleknél 2026. december 31-ig érvényes. 2027. január 1-jétől az 1,50 és 7,50 dolláros normál ár lép érvénybe, vagyis a díj az új költségvetési év első napján megduplázódik.
- Az OpenAI a GPT-5.6 Sol 4 dolláros bemeneti árát akciós árként tünteti fel, és ez legalább 2026. november 21-ig érvényes.
- Az OpenAI 2026. július 30-án, három héttel azután, hogy a modellcsalád általánosan elérhetővé vált, 20%-kal csökkentette a GPT-5.6 Terra és 80%-kal a Luna árát.
Az árak emelkedhetnek is, és a bejelentett emelés el is maradhat. Az Anthropic azt tervezte, hogy 2026. szeptember 1-jén 2, illetve 10 dollárról 3, illetve 15 dollárra emeli a Claude Sonnet 5 árát, majd megerősítette, hogy az emelés elmarad, és a bevezetéskori árat tette véglegessé. Aki ezzel az emeléssel tervezett, annak a 2026-os keretében most tartalék maradt.
A 2027-es költségvetéshez a gyakorlati tanulság a következő: az akció utáni listaárral kell számolni, a mai árat átmeneti kedvezménynek kell tekinteni, a modellválasztást pedig konfigurációs beállításként érdemes kezelni, hogy a váltás egy délutánnyi munka legyen.
Az egységár csökken, a teljes számla mégis nő
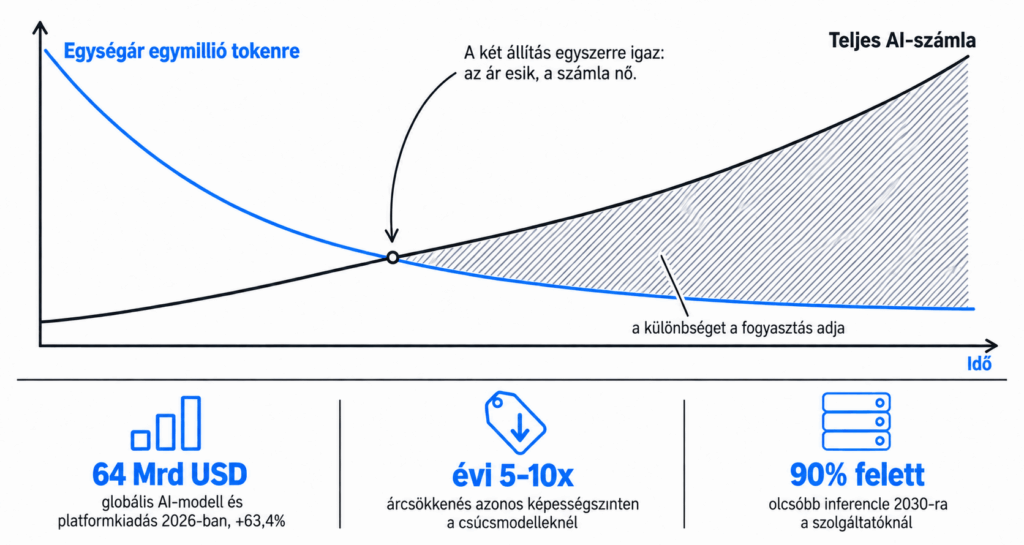
Hosszú távon az irány egyértelmű. Az Epoch AI azt vizsgálta, milyen gyorsan csökken az ár, amelyért adott képességszint elérhető, és tesztkészlettől függően évi 9-szeres és 900-szoros közötti csökkenést mért. A The Price of Progress című tanulmány, amely tesztenként követi az árak alakulását, a csúcsmodelleknél évi 5-szörös és 10-szeres közötti csökkenést mutat ki; ebből az algoritmusok hatékonyabbá válása önmagában évi nagyjából 3-szoros javulást hoz. A két módszer más nagyságrendre jut, az irányt viszont ugyanúgy látja. A Gartner előrejelzése szerint 2030-ra az egybillió paraméteres modellek inferenciája több mint 90%-kal kevesebbe kerül majd a szolgáltatóknak, mint 2025-ben.
Van azonban ellensúly is. A Gartner egyértelműen kimondja, hogy ez a megtakarítás csak részben jut el a vállalati ügyfelekhez, és hogy a csúcsmodellek képességeihez jóval több token kell majd, mint a mai átlagos alkalmazásokhoz. Mivel a fogyasztás gyorsabban nő, mint ahogy az egységárak csökkennek, a teljes inferenciaköltség várhatóan emelkedik. Will Sommer, a Gartner vezető elemzője, aki az előrejelzést jegyzi, abban látja a csapdát, hogy a tömegcikké vált tokenek olcsóbbodását összetévesztik azzal, amit ő úgy nevez, hogy „az élvonalbeli gondolkodás demokratizálódása”.
A piaci adatok ugyanezt mutatják. A Gartner 2026. júliusi előrejelzése szerint az AI-modellekre és az AI-platformokra fordított globális végfelhasználói kiadások 2026-ban elérik a 64 milliárd dollárt, ami 63,4%-os növekedés a 2025-ös 39 milliárdhoz képest. Az egységárak zuhannak, miközben a számlák nőnek, és a két állítás egyszerre igaz.
A mérleg másik serpenyője hét tételből áll
Az ügyfélszolgálati asszisztens költségszámítása akkor védhető, ha megvan benne ez a hét tétel, és olyan számmal kezdődik, amelyet csak a saját ügyfélforgalmán lehet megmérni.
- Tokenszám beszélgetésenként. Ezt a cég saját tartalmain, magyarul és a tényleges visszakeresési beállításokkal kell mérni. Futtasson le 200 valódi beszélgetést a pilotban, és számolja meg a tokeneket. Minden más szám ebből az egyből következik.
- Lezárási arány. Külön kell beárazni azokat a beszélgetéseket, amelyeket az asszisztens önállóan lezár, és azokat, amelyeket eszkalál, hiszen az eszkalált beszélgetésért előbb a tokeneket, majd a munkatárs idejét is kifizetjük.
- A kérések elosztása a modellek között. Az osztályozást, a szándékfelismerést és a rövid, tényszerű válaszokat az olcsó modellekhez kell irányítani, a csúcsmodelleket pedig arra a kevés esetre kell tartogatni, amelyhez valóban szükség van rájuk. A fenti táblázatban ötvenszeres a különbség.
- Gyorsítótárazás és kötegelt feldolgozás. A rendszerpromptot és az állandó tudásbázist a bemeneti ár 10%-áért lehet gyorsítótárazni, az éjszakai feladatokat pedig féláron, a Batch API-n keresztül érdemes futtatni.
- Költségkorlátok. Az API-konzolban szigorú havi felső korlátot kell beállítani, még mielőtt bárki kulcsot kapna. A használatalapú árazásnak nincs természetes felső határa, és ahol egy keret egy hét alatt kiürült, ott mindig a korlát hiányzott.
- A 2027-es listaár. A mai akciós árat átmeneti kedvezménynek kell tekinteni, amelynek a lejárati dátuma már ma is ott áll az árlistán.
- Az inferenciánál sokkal nagyobb költségek. Ide tartozik a CRM- és a telefonrendszer összekötése az asszisztenssel, az adatok előkészítése, a kiértékelés, a monitorozás, valamint azok munkája, akik az asszisztenst felügyelik. A legtöbb projektben, amellyel találkozunk, az első évben a token a legkisebb tétel.
Az inferenciaköltség tehát csak egy része a teljes képnek. Az integráció, a belső időráfordítás, a tesztelés és a folyamatos üzemeltetés gyakran jóval nagyobb tételt jelent. Ezeket a rejtett költségeket részletesebben bemutatjuk a A rejtett költségek anatómiája egy AI-projektben →
Az őszinte válasz két részből áll
A reggelin az üzletágvezető jól kérdezett, és a válasz egyik fele az, hogy a tokenárak 2026 szeptemberében elég alacsonyak ahhoz, hogy az ügyfélszolgálati projekt üzleti terve csak ritkán múljon az inferencia költségén. A másik fele az, hogy a tokenfogyasztás elég kiszámíthatatlan ahhoz, hogy a mérés nélkül bevezetett rendszer a második negyedévben így is meglepje a pénzügyi igazgatót. Mindkét félnek helye van a dián, a másodikat pedig csak az tudja meg, aki a saját ügyfélforgalmán, a saját nyelvén és a saját dokumentációján méri meg.
Ha tehát legközelebb a szállító a megtakarított létszámot mutatja be, kérje mellé a tokenköltség számítását is. Ha a válasz egyetlen szám, amelyhez nem tartozik lezárási arány, nyelvi szorzó és az ár lejárati dátuma, akkor a becslés még el sem készült.
Töltse meg mért számokkal a mérleg mindkét serpenyőjét
Ha a szervezet AI-alapú ügyfélszolgálat bevezetését mérlegeli, és a költségoldal még csak becslés, cserélje le mért számokra: erre a strukturált felmérés a leggyorsabb út. Az AI Opportunity Check célzott, fix díjas felmérés 1450 euróért: egy workshop, írásos összefoglaló és egyértelmű válasz arra, hogy érdemes-e most pilotot indítani. Az AI Compass Audit ennek a 4 hetes, fix díjas változata azoknak a szervezeteknek, amelyek több felhasználási esetet térképeznek fel egyszerre, és mindegyikhez sikerkritériumokat és kockázatokat rendelnek.
Források
Anthropic. (2026). Claude Platform Pricing. A Claude modellek díjainak, a prompt-gyorsítótárazásnak, a kötegelt feldolgozás árának, a tokenizálóra vonatkozó megjegyzésnek és az ügyfélszolgálati példaszámításnak a forrása. Cikk megnyitása →
Epoch AI. (2026). LLM Inference Price Trends. A rögzített képességszintek mellett mért, évi 9-szeres és 900-szoros közötti inferencia-árcsökkenés forrása. Cikk megnyitása →
Gartner. (2026, március 25.). Gartner Predicts That by 2030 Performing Inference on an LLM With 1 Trillion Parameters Will Cost GenAI Providers Over 90% Less Than in 2025. A 2030-ig várható inferenciaköltség-csökkenés, az AI-ügynökök 5–30-szoros tokenigénye és Will Sommer kapcsolódó megállapításainak forrása. Cikk megnyitása →
Gartner. (2026, július 20.). Gartner Forecasts Worldwide AI Platforms and Models Market to Grow 63 Percent in 2026. A 2026-os, 64 milliárd dolláros globális végfelhasználói AI-költés és a 63,4%-os éves növekedés forrása. Cikk megnyitása →
Google Cloud. (2026). Agent Platform Generative AI Pricing. A Gemini modellek díjainak, a 2026 végéig érvényes akciós áraknak, a nem globális végpontok felárának és az átiratkészítés díjainak forrása. Cikk megnyitása →
Omnit. (2026). Why LLMs Are Weaker in Hungarian. A magyar nyelv tokenizálásának, valamint annak költség- és kontextushatásainak forrása. Cikk megnyitása →
OpenAI. (2026). API Pricing. A GPT-6 Astra és GPT-5.6 modellek díjainak, a gyorsítótárazott bemenetnek, a hosszú kontextus díjszabásának, valamint a valós idejű hang és a webes keresés árainak forrása. Cikk megnyitása →
The Price of Progress. (2025). A tesztenként mért, évi 5–10-szeres AI-árcsökkenés és a nagyjából évi 3-szoros algoritmikus hatékonyságjavulás forrása. Cikk megnyitása →
Fehér Lajos
Fehér Lajos informatikai szakértő, közel 30 év tapasztalattal az adatbázis-fejlesztés, különösen az Oracle-alapú rendszerek, valamint az adatmigrációs projektek és a magas rendelkezésre állást, illetve skálázhatóságot igénylő rendszerek tervezése területén. Az elmúlt években munkája mesterséges intelligenciára épülő megoldásokkal is kiegészült, az üzleti szempontból mérhető értéket teremtő rendszerek kialakítására fókuszálva.
Kapcsolódó cikkek
Miért akad el olyan sok AI-projekt — és hogyan léphetsz végre túl a pilot fázison
Biztos benne, hogy az AI a megfelelő következő lépés?
Segítünk feltárni a valódi lehetőségeket, korlátokat és a reális következő lépéseket.