„Nem találjuk a cikket, pedig ott van a törzsben”
A duplikált cikkek a kifejezéseknél kezdődnek
- AI az üzletben
- 12 perc
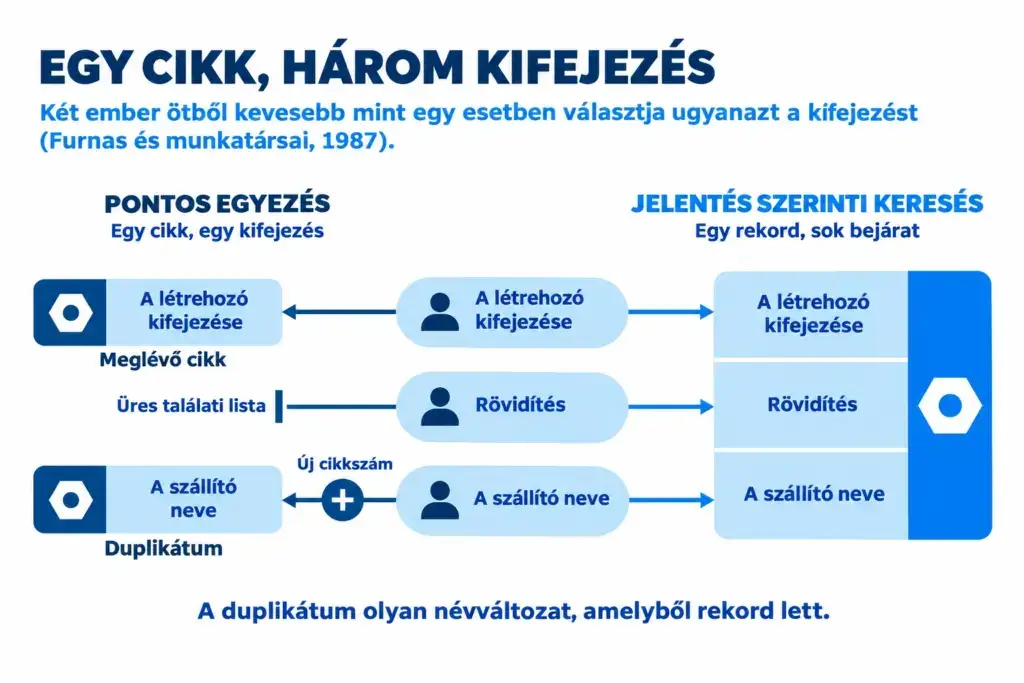
Két ember, aki ugyanazt a dolgot nevezi meg, többnyire más-más kifejezést választ. 1987-ben kutatók megmérték ezt: két ember kifejezése minden vizsgált területen ötből kevesebb mint egy esetben egyezett. Szimulációikban az a rendszer, amely minden tárgyat egyetlen néven, a tervezője kedvenc kifejezésével tárolt, sok hétköznapi helyzetben az esetek 80-90%-ában nem találta meg, amit kerestek. A cikktörzs ugyanígy működik: minden cikknek egyetlen leírása van, azt a létrehozója választotta, a többieknek pedig ezt kell eltalálniuk, amikor keresnek. Ha a keresés nem hoz találatot, a kereső gyakran új cikket kér, és a törzsbe duplikátum kerül.
A címben idézett mondatot ügyfeleinktől halljuk, és elsőre kézenfekvő a keresést végző kollégát hibáztatni. Valaki felületesen keresett a cikktörzsben, nem talált semmit, és újként kérte a cikket. Amikor később más néven előkerül az eredeti, kiderül, hogy a törzsben kétszer szerepel ugyanaz a cikk.
A Communications of the ACM 1987. novemberi számában megjelent tanulmány máshol keresi az okot. George Furnas, Thomas Landauer, Louis Gomez és Susan Dumais azt vizsgálták, milyen kifejezésekkel nevezik meg az emberek maguktól a tárgyakat öt olyan területen, amely számítógépes alkalmazásokhoz kötődik. Az esély, hogy két ember ugyanazt a kifejezést választja, minden területen 0,2 alatt maradt. Szimulációikban ezután azt az elterjedt megoldást is kipróbálták, amely minden tárgyat egyetlen néven, a tervezője kedvenc kifejezésével tárolt; ez sok hétköznapi helyzetben az esetek 80-90%-ában nem találta meg, amit kerestek.
Miért nem találja tehát a keresés azt a cikket, amely ott van a törzsben? A keresés a kifejezésen dől el. A cikket az egyik ember leírásával rögzítették, a kereső pedig a saját szavaival keres. A pontos egyezésre épülő keresés a létrehozó kifejezéseit találja meg, mindenki máséit nem. Ha a találati lista üres marad, a feladatot az új cikkszám kérésével lehet a legbiztosabban lezárni.
Ez az írás megnevezi a mechanizmust, megmutatja, hogyan lesz az eredménytelen keresésből duplikátum, és azt is, mibe kerül ez. Az írást 15 perces teszt zárja, amelyet az utolsó tíz új cikkén elvégezhet.
A jelenség a saját cégénél is felismerhető
Ezt az öt jelet érdemes megnézni a saját cégénél:
- A cikktörzsben a keresés üres találati listát ad, a régóta ott dolgozó kolléga pedig egy perc alatt megtalálja a cikket, mert emlékszik, hogyan hívták.
- Olyan dolgokra érkezik új cikk iránti igény, amelyeket a cég már most is vásárol, és a törzsadatcsapatban valaki azzal tölti az idejét, hogy egyenként ellenőrzi, létezik-e már a cikk.
- Ugyanaz az alkatrész két vagy három cikkszámon szerepel a törzsben, és a leírások csak a rövidítésekben, a szórendben vagy a nyelvben térnek el.
- A tapasztalt kollégák saját Excel-táblát vezetnek a cikkszámokról, az újak pedig előbb tőlük kérdeznek, és csak utána keresnek.
- A rendszer azt jelzi, hogy a cikk nincs készleten, miközben ugyanaz az alkatrész más cikkszámon ott van a polcon.
Ha ebből kettő igaz a cégére, a következő kérdés az, miért nem találja a keresés azt a cikket, amely már ott van a törzsben.
A keresés a nyelvnél akad el, nem a kollégánál
Általában három magyarázat hangzik el először. A kolléga felületesen keresett. Az oktatás túl rövid volt. A törzsadat rendezetlen. Mindhárom lehet részben igaz, és mindhárom az emberben vagy a rekordokban keresi a hibát. Az 1987-es kutatás a hiba jó részét a nyelvben találja meg.
Két ember ritkán nevezi ugyanúgy ugyanazt a dolgot
Furnas és szerzőtársai kiindulópontja egyszerű megfigyelés volt: szinte minden számítógépes alkalmazás azt várja a felhasználótól, hogy a rendszer saját kifejezését gépelje be arra, amit keres. Aki új a rendszerben, vagy először próbál valamit, az a saját kifejezéseit használja, ezért a rendszernek ezeket is értenie kell. A kutatók tehát azt nézték meg, milyen kifejezésekkel nevezik meg az emberek maguktól a tárgyakat öt területen. A válaszok feltűnően sokféle kifejezés között oszlottak meg.
Magyarán: ha két embert megkérünk, hogy nevezzék meg ugyanazt a dolgot, ötből több mint négy esetben más kifejezést mondanak. A kutatók ezután több módszert is szimuláltak arra, hogyan lehet a tárgyakat kifejezések alapján megtalálhatóvá tenni. Az elterjedt megoldás minden tárgyat egyetlen néven, a tervezője kedvenc kifejezésével tárolt, és ez sok hétköznapi helyzetben a próbálkozások 80-90%-ában nem találta meg, amit kerestek.
A tanulmány címe nevet is ad a jelenségnek: szókincsprobléma, angolul vocabulary problem. Az emberek sokféle kifejezést használnak ugyanarra a dologra, ezért az a rendszer, amely egyetlen meghatározott kifejezésre vár, a keresők többségének nem ad találatot.
A szám a szerzők későbbi munkáiban is visszatér. 1990-ben hárman közülük két további kollégával együtt újra közölték az eredményt a Journal of the American Society for Information Science hasábjain. Eszerint két ember ötből kevesebb mint egy esetben választja ugyanazt a fő keresőkifejezést, ha ismerős tárgyat kell megnevezniük. Ugyanez a tanulmány korábbi kutatásokra hivatkozva hasonlóan gyenge egyezésről számol be az azonos dokumentumokat címkéző indexelőknél, valamint a képzett keresési szakembereknél és a kevésbé tapasztalt keresőknél is, amikor keresőkifejezést választanak.
A cikktörzs ugyanerre a mintára épül
Ezeket a számokat szem előtt tartva nézzen rá a cikktörzsre. Minden cikk egyszer kerül be, azzal a leírással, amelyet a létrehozója adott neki. Ebben olyan rövidítés áll, amelyet ő kedvel, olyan szórend, amely neki kézre áll, néha az a név, amelyet a szállító használ az alkatrészre. Aki később keresi, a saját szavaival próbálkozik. Ez ugyanaz a felépítés, amelyet az 1987-es szimulációk próbára tettek, csak itt több ezer cikken ismétlődik: minden cikkhez egyetlen kifejezés tartozik, és azt egyetlen ember választotta.
Hogy ez mibe kerül, azt az Omnit Törzsadatkezelés oldala így foglalja össze: ha ugyanaz a cikk ötször szerepel, abból hibás megrendelés, rossz készletadat és vitatott jelentés lesz. A keresés annak találja meg a cikket, aki már ismeri a cikkszámát vagy a teljes leírását; mindenki más számára a rekord ott vár a rendszerben.
Egy ember egyetlen néven rögzítette a cikket. Mindenki más a saját szavaival keresi.
Az üres találati listából új cikkszám lesz
A mechanizmus második fele akkor indul, amikor a találati lista üres marad. A keresőnek feladata van, amelyet be kell fejeznie: rendelést kell feladnia, javítást rögzítenie, szállítmányt bevételeznie. Még egy kör keresés más kifejezésekkel további időbe kerül, és ugyanúgy végződhet. Az új cikkszám igénylése viszont biztosan célba ér, ezért beadja az igényt, és a cikk másodszor is bekerül a törzsbe, azzal a kifejezéssel, amelyet most ő választott.
A duplikált CRM-leadekről szóló írásunk ugyanezt az utat mutatja be: az ügyfél nevét másképp rögzítették, a keresés nem találja meg a meglévő ügyfelet, az értékesítő pedig új rekordot nyit. Azt is megmutatja, milyen apró lehet a kiváltó ok. A példájában a webes űrlap elhagyta az ékezeteket az ügyfél nevéből, és onnantól a névre indított keresések nem találták meg a rekordot. A hiteles ügyfélrekordról szóló írásunk ugyanezt a mintát a frissen felvett értékesítőnél írja le, aki nehezen találta meg a meglévő ügyfelet, és második rekordot nyitott.
Ebből a szemszögből a duplikátum a meglévő cikk második neve, amely rossz helyre került. A második kereső szava hasznos volt: az emberek így is nevezik ezt a cikket. A meglévő rekordon lett volna a helye névváltozatként, ehelyett új rekordba került.
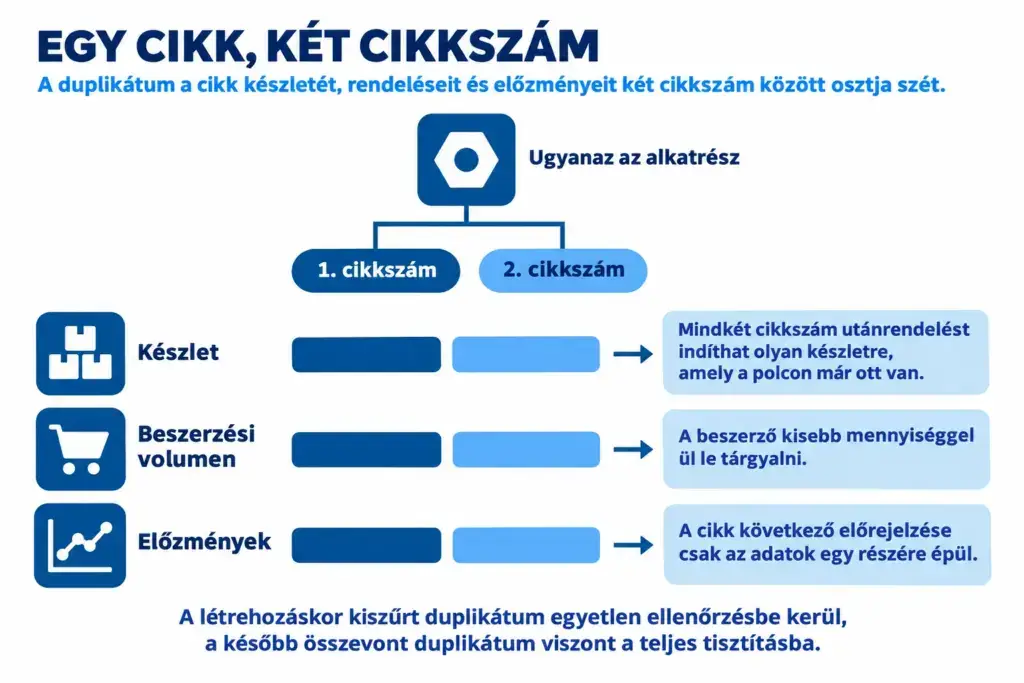
Innentől a folyamat önmagát erősíti. A duplikátum a cikk készletét, rendeléseit és előzményeit két cikkszám között osztja szét, és a törzs már két leírást őriz ugyanarról a dologról. A következő kereső bármelyik rekordot megtalálhatja, vagy egy harmadik kifejezéssel próbálkozik, amellyel egyiket sem találja meg.
A duplikátum olyan névváltozat, amelyből végül új rekord lett.
Arról, miért kerülik meg a munkatársak csendben a nehezen használható vállalati szoftvereket, ebben a cikkünkben írtunk: A szoftver, amit a dolgozók csendben kikerülnek →
Négy korlát, amely megmutatja, meddig érvényes az állítás
Az alábbi négy megszorítás teszi pontossá az állítást.
A cikktörzsre mi vonatkoztattuk az eredményt. Az 1987-es tanulmány öt olyan területet vizsgált, amely számítógépes alkalmazásokhoz kapcsolódik. Hogy az eredmény a cikktörzsre is érvényes, az a mi értelmezésünk; az alábbi tesztek azt mérik, mennyire igaz ez a saját cikktörzsére.
A közös azonosító mellett nincs mit találgatni. Ahol mindenki ugyanazzal az azonosítóval keres, például a gyártói cikkszámmal vagy a vonalkóddal, ott mindenki ugyanazt a karaktersort gépeli be, és a szókincsprobléma összezsugorodik. Amint valakinek a saját kifejezéseivel kell leírnia a cikket, a probléma visszatér.
Kis, állandó csapatban a probléma is kicsi marad. Ahol évről évre ugyanaz a kis csoport hozza létre és keresi a cikkeket, a keresőbe mindig ugyanazok a szavak kerülnek. A probléma annál nagyobb, minél többen keresnek, minél régebb óta gyarapszik a törzs, és minél többféle cikk van benne.
Több név több lehetséges találatot ad. Ha több kifejezést veszünk fel, annak ára is van, és az 1990-es tanulmány ezt is mérlegeli. Kis, interaktív adatbázisokban a további indexkifejezések növelték a teljességet (recall), miközben a pontosság (precision) összességében nem romlott; nagyon nagy gyűjteményeknél a szerzők figyelmeztettek, hogy többértelműség léphet fel, és romolhat a pontosság. A cikktörzsben ez azt jelenti, hogy ha a keresés több kifejezést fogad el, a találati listán a megfelelő cikk mellett mások is megjelennek, ezért a végső döntést ember hozza meg.
Ahol az emberek a saját kifejezéseikkel írják le a cikkeket, ott cikkenként sok kifejezéssel kell számolni.
Az eredménytelen keresésnek kiszámolható ára van
A költség három helyen jelentkezik, és mindegyik kiszámolható a saját rendszereinek számaiból.
Az első hely a keresés. Minden eredménytelen keresés után újra kell keresni, meg kell kérdezni valamelyik kollégát, vagy meg kell kérni a törzsadatcsapatot, hogy ellenőrizze, létezik-e a cikk. Az egyes esetek kicsik, és az idő sok ember között oszlik el, ezért ez a költség a jelentésekben nem látszik.
A második hely a duplikátum. Ez egyetlen cikket két cikkszám között oszt szét. A készletéből két kisebb készlet lesz, ezért mindkét cikkszám utánrendelést indíthat olyan áruból, amely már ott van a polcon. A beszerzési volumen is kettéválik, és a beszerző kisebb mennyiséggel ül le tárgyalni. Az előzmények is szétválnak, ezért a cikk következő előrejelzése csak az adatok egy részére épül.
A harmadik hely a tisztítás. Előbb-utóbb valaki észreveszi, hogy két cikkszám ugyanazt jelöli, és összevonja őket: a nyitott rendeléseket, a készletet, az előzményeket és a dokumentumokat egy cikkszámra viszi át. A duplikált leadekről szóló írásunk megállapítása a cikkekre is érvényes: a rekordot a létrehozása napján a legolcsóbb javítani. A létrehozáskor kiszűrt duplikátum egyetlen ellenőrzésbe kerül, a később összevont duplikátum viszont a teljes tisztításba.
Arról, hogyan torzítják a duplikált rekordok a jelentéseket és az értékesítési előrejelzést, a Duplikált leadek a CRM-ben → című cikkünkben írtunk.
A képlet elfér egy sorban. Vegye a tavaly létrehozott új cikkek számát. Szorozza meg azzal az aránnyal, amekkora részük már más néven létezett; ezt méri az alábbi teszt. Az eredményt szorozza meg egy duplikátum költségével: az igénylésre és a létrehozásra, majd a későbbi megtalálásra és összevonásra fordított idővel, valamint a második cikkszámon tartott többletkészlet értékével.
Számolja össze a kétszer létrehozott cikkeket, és látni fogja, mibe kerül a szókincsprobléma.
A szokásos négy lépés a mechanizmust nem érinti
Általában négy lépéssel próbálkoznak először. Mindegyik hoz némi javulást, és mindegyik megtartja a keresés középpontjában az „egy cikk, egy kifejezés” elvet.
Az első az oktatás és a figyelmeztetés, hogy keressenek gondosabban. Ez azt kéri a keresőtől, hogy találja ki, melyik kifejezést választotta a létrehozó, az 1987-es számok szerint pedig az első tipp ötből kevesebb mint egy esetben ér célba.
A második az elnevezési szabályzat: ez kötött szórendet, jóváhagyott rövidítéseket és egyetlen nyelvet ír elő. Az egységes elnevezés az új leírásokat következetesebbé teszi, és ez segít. A kereső viszont a saját kifejezéseit gépeli, a szabály előtt rögzített cikkek pedig megtartják régi leírásukat. Az 1987-es tanulmány mércéje szerint a szabályzat annyit változtat, hogy az egyetlen kifejezést ezentúl nem egy ember, hanem bizottság választja.
A harmadik az egyszeri tisztítás. Az egyszeri összevonás eltünteti a mai duplikátumokat, a változatlan keresési szokások pedig már a következő napon újakat termelnek. A duplikált CRM-leadekről szóló írásunk szerint a duplikátumok aránya körülbelül három hónapon belül visszaáll a régi szintre.
A negyedik a jóváhagyási lépés minden új cikknél. A törzsadatcsapat kapuőre minden igényt ellenőriz, mielőtt kiadná a cikkszámot. Ez a lépés kiszűr néhány duplikátumot, csakhogy a kapuőr ugyanazokkal az eszközökkel keres, és ugyanabba a szókincsproblémába ütközik. Ráadásul várakozási sor is kialakul előtte; erről szól az az írásunk, amely azt járja körül, miért tart hetekig, amíg az új cikk bekerül a törzsbe.
Mindegyik lépés az embereket vagy a rekordokat próbálja javítani. Az a lépés, amely magát a mechanizmust javítja, azt változtatja meg, mit fogad el a keresés. Cikkenként sok kifejezést fogad el, a jelentés alapján működik, és abban a pillanatban keres, amikor valaki épp új cikket akar létrehozni.
Tegye a keresést oda, ahol a duplikátumok születnek: az új cikk létrehozásának pillanatába.
A két tanulmány a megoldás irányát is megadja
Ez az írás két kutatási tanulmányra épül. 1987-ben Furnas, Landauer, Gomez és Dumais a Communications of the ACM hasábjain leírták és megmérték a szókincsproblémát: két ember ötből kevesebb mint egy esetben választja ugyanazt a kifejezést. Gyógymódnak a korlátlan névváltozatot javasolták, angolul unlimited aliasing: minden tárgyat meg lehessen találni mindazokkal a kifejezésekkel, amelyeket az emberek használnak rá. A tanulmány szerint ez a sikeres keresések arányát a többszörösére emelheti.
Az 1990-es tanulmány, amelyet Scott Deerwester, Susan Dumais, George Furnas, Thomas Landauer és Richard Harshman írt, a látens szemantikus indexelés módszerét vezette be, angolul latent semantic indexing. A kiindulópontot egyszerűen fogalmazza meg. Azok a kifejezések, amelyekkel a dokumentumot indexelik, csak kis részét fedik le annak, amit az olvasói majd beírnak. Ha a dokumentum saját szövegén kívülről is gyűjtünk indexkifejezéseket, az a gyűjtemény növekedésével egyre nehezebb munka. A módszer a kifejezéseket és a dokumentumokat közös térben helyezte el, amelyet az együttes előfordulásuk mintázataiból épített fel, így a dokumentum közel kerülhet az olyan kereséshez is, amelyet más kifejezésekkel fogalmaztak meg.
A kidolgozott példájukban az ember-számítógép interakcióról szóló lekérdezés két olyan releváns feljegyzéscímet is megtalált, amelyek megfogalmazása teljesen eltért a lekérdezésétől. A szerzők visszafogottan fogalmaztak. Orvosi kivonatokon a módszer átlagos pontossága 13%-kal volt jobb a kifejezések egyszerű egyezésénél; információtudományi kivonatokon a kettő azonos eredményt ért el. Saját összegzésük: „Ezek az eredmények mérsékelten biztatóak.”
Mindkét tanulmányból ugyanazt a tanulságot visszük tovább: a szókincsprobléma a nyelv sajátja, ezért a megoldásnak a rendszerben van a helye, egyetlen rekorddal és sok bejárattal. Abban térünk el tőlük, hogy melyik pillanat számít. Mindkét tanulmány magát a keresést vizsgálja: azt, amit az ember begépel, és azt, ami visszajön. A cikktörzsben a döntő pillanat az eredménytelen keresés után jön, amikor valaki épp új cikket akar létrehozni.
Mi ide tennénk a jelentésalapú keresést. Mielőtt a rendszer új cikkszámot adna ki, a keresés megmutatja a legközelebbi meglévő cikkeket, és ha a kereső kiválasztja egyiküket, a kifejezése új névként ott marad azon a rekordon. Az eredménytelen keresőkifejezésből így névváltozat lesz, a duplikátum pedig kimarad a törzsből.
Öt kérdés, két teszt és három lépés a saját cikktörzséhez
Az önellenőrzés öt kérdésből áll. Igennel vagy nemmel válaszoljon. Ha háromszor vagy többször nem a válasz, a szókincsprobléma duplikátumokkal tölti meg a törzsét.
- Megtalálja a cikk-keresője a cikket akkor is, ha a leírást más kifejezésekkel fogalmazták meg?
- Mielőtt új cikket igényelnek, rákeres valaki legalább két különböző kifejezéssel?
- Tárol a törzs cikkenként több nevet, például régi cikkszámokat, rövidítéseket és azokat a kifejezéseket, amelyeket a kollégák használnak?
- Tudja, hogy a tavalyi új cikkek közül hány létezett már más néven?
- Van kijelölt gazdája a cikktörzsnek, aki havonta átnézi, van-e duplikátum az új cikkek között?
A 15 perces teszt a második kifejezésről szól. Vegye a törzsében legutóbb létrehozott tíz cikket. Mindegyikhez írjon fel két másik kifejezést, amellyel a kollégák megnevezhetnék: lehet ez szinonima, bevett rövidítés, a szállító neve az alkatrészre, vagy a régi cikkszám, ha volt. Keressen rá a törzsben mindegyikkel, és jegyezze fel, előkerül-e régebbi cikk, amely ugyanazt jelöli. Az, hogy a tízből hány volt már benne korábban, megadja a duplikációs arányt a létrehozás pillanatában.
Az egyórás teszt a második emberről szól. Válasszon ki öt cikket, és három kollégának, akik különböző osztályokon dolgoznak, adjon mindegyikről csak egy fotót vagy egyetlen mondatnyi leírást arról, mire használják. Kérje meg mindegyiküket, hogy a megszokott módján keresse meg a cikkeket a törzsben, Ön pedig számolja össze, hány esetben találják meg a helyes rekordot két próbálkozásból. Az eredmény az 1987-es mérés saját, kicsinyített változata.
Három lépést már a meglévő eszközeivel is megtehet.
- Tegye szabállyá, hogy új cikket csak azután lehet igényelni, hogy két különböző kifejezéssel is kerestek, és az igénylő mindkét kifejezést ráírja az igénylésre.
- Ha a cikk a második kifejezéssel kerül elő, írja hozzá az első kifejezést is abba a mezőbe, amelyet a rendszere alternatív leírásra vagy keresőkifejezésre kínál.
- Egy hónapon át gyűjtse össze az eredménytelen kereséseket, és nézze át a listát a cikktörzs gazdájával: minden tétel olyan kifejezés, amelyet érdemes felvenni a törzsbe.
Amit érdemes megjegyezni
A név: a jelenséget szókincsproblémának hívják. Az emberek sokféle kifejezést használnak ugyanarra a dologra, ezért az egyetlen kifejezésre váró keresés a keresők többségének nem ad találatot.
A szám: két ember ötből kevesebb mint egy esetben választja ugyanazt a kifejezést (Furnas és munkatársai, 1987). Ugyanennek a tanulmánynak a szimulációiban az a rendszer, amely minden tárgyat egyetlen néven, a tervezője kedvenc kifejezésével tárolt, sok hétköznapi helyzetben az esetek 80-90%-ában nem találta meg, amit kerestek.
Az eszköz: végezze el a második kifejezés tesztjét az utolsó tíz új cikkén.
Az első lépés: mielőtt új cikket igényelne, keressen két különböző kifejezéssel, és azt a kifejezést, amellyel megtalálta, őrizze meg a rekordon.
Nem a kollégákról szól a cím mondata, hanem a törzsadatról
A „nem találjuk a cikket, pedig ott van a törzsben” mondat úgy hangzik, mintha a kollégákra panaszkodnánk. Az 1987-es számok fényében azonban magát a törzsadatot írja le: minden cikkhez egyetlen leírás tartozik, amelyet egy ember írt meg, a többiek pedig a saját szavaikkal keresik; a kettőt pontos egyezésre épülő keresés köti össze.
A gyógymód a kutatásból következik: minden rekordhoz több bejárat vezessen, a keresés a jelentés alapján működjön, és abban a pillanatban fusson le, amikor az új cikk épp létrejönne. Az Omnit AI Cikk-keresője, amely a CER törzsadatkezelési keretrendszerünkben működik, a cikkeket a jelentésük alapján találja meg, és ismeri a régi cikkszámaikat, rövid alakjaikat és alternatív neveiket. Maga a CER minden új cikk iránti igényt egyetlen ellenőrzött kapun vezet át az SAP előtt.
A saját cégére vonatkozó kérdés 15 perc alatt megválaszolható: az utolsó tíz új cikkéből hány volt már ott más néven?
Két ember két kifejezést mond egy cikkre. Mindkét kifejezés helye egy rekordon van.
Kié az adat a saját cégénél?
Az eredménytelen keresés nem az egyetlen út, amelyen a törzs megtelik duplikátumokkal. Ha a cikktörzse SAP-ot vagy más ERP-t lát el adattal, az Omnit AI Cikk-keresője a cikkeket a jelentésük alapján találja meg, a régi cikkszámokkal és rövid alakokkal együtt. Ugyanannak a cikknek a változatait egyetlen rekordba vonja össze. A cél az, hogy a törzsadat gazdája meg tudja mondani a pénzügyi igazgatónak, hány különböző cikke van a cégnek, és vállalni is tudja ezt a számot.
Ha ez az oldal hasznos volt, a hírlevél is az lesz.
Havonta egy levél a vállalati AI, adat és folyamatok gyakorlatáról, hazavihető tanulsággal. Bármikor leiratkozhat.
Források
- Furnas, G. W., Landauer, T. K., Gomez, L. M. és Dumais, S. T. (1987). The Vocabulary Problem in Human-System Communication. Communications of the ACM, 30(11), 964-971. Cikk megnyitása →
- Deerwester, S., Dumais, S. T., Furnas, G. W., Landauer, T. K. és Harshman, R. (1990). Indexing by Latent Semantic Analysis. Journal of the American Society for Information Science, 41(6), 391-407. Cikk megnyitása →
- Omnit. (2026). Törzsadatkezelés ERP-csere és S/4HANA-átállás előtt. Oldal megnyitása →
- Omnit. (2026). Duplikált leadek a CRM-ben. Cikk megnyitása →
- Omnit. (2026). Melyik a hiteles ügyfélrekord. Cikk megnyitása →

Fekszi Csaba
Fekszi Csaba informatikai szakértő, több mint két évtizedes tapasztalattal az adatmérnökség, a rendszerarchitektúra és az AI-alapú folyamatoptimalizálás területén. Munkájának középpontjában olyan skálázható megoldások tervezése áll, amelyek mérhetően javítják az üzleti eredményt.
Kapcsolódó cikkek
Az AI-projektek adatminősége jóval az első modell betanítása előtt eldönti a projekt végeredményét