Miért buknak el az AI-projektek data governance nélkül
Az AI-projektek adatminősége jóval az első modell betanítása előtt eldönti a projekt végeredményét
- AI az üzletben
- 6 perc
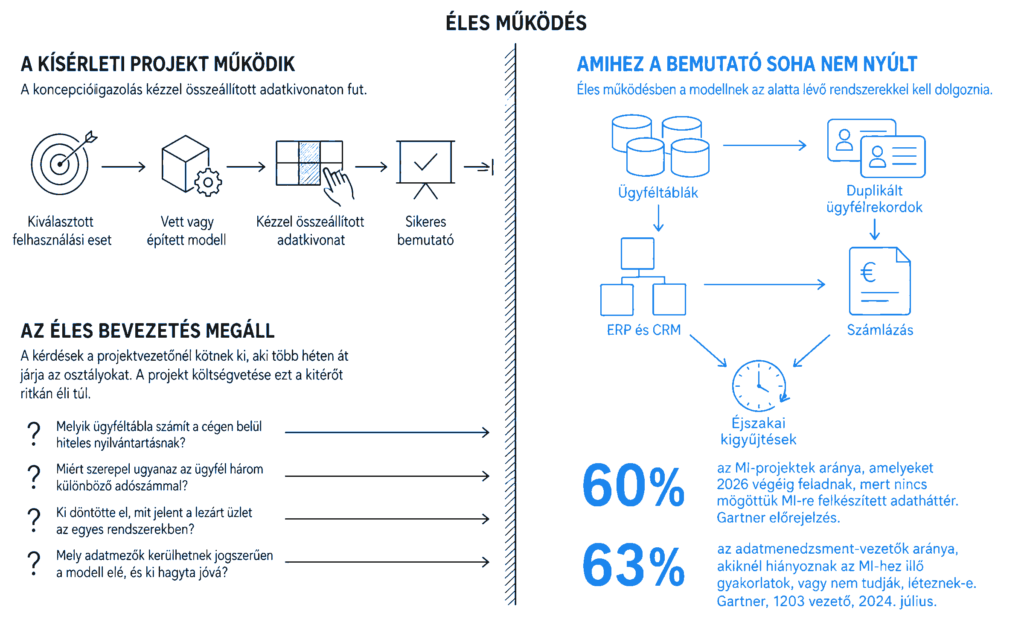
A Gartner előrejelzése szerint 2026 végéig a vállalatok feladják azoknak a mesterségesintelligencia-projekteknek a 60%-át, amelyek mögött nincs AI-ra felkészített adatháttér. Ezt a felmérést a Gartner 2025 februárjában tette közzé. Az eredmény 1203 adatmenedzsment-vezető 2024. júliusi válaszain alapul. Ugyanez a kutatás a 60% mellé egy másik számot is odatesz: a megkérdezett vezetők 63%-ánál vagy hiányoznak az AI-hoz illő adatmenedzsment-gyakorlatok, vagy maguk a vezetők sem tudják, léteznek-e ilyenek a cégükben.
Ezek a számok egy olyan kudarcot jeleznek, amely csak hónapokkal a sikeres, mindenki által ünnepelt pilotbemutató után válik láthatóvá.
A kísérleti projekt működik, az éles bevezetés megáll
Az AI-projektek kísérleti szakaszának kudarca iparágtól és cégmérettől függetlenül ugyanazt a mintát követi. A csapat kiválaszt egy ígéretes felhasználási esetet, modellt vesz vagy épít, és koncepcióigazolást futtat kézzel összeállított adatkivonaton. A bemutató jól sikerül. Aztán a projekt elindul az éles működés felé, ahol a modellnek már élő rendszerekkel kell dolgoznia, és a haladás előbb lelassul, majd megáll.
Ekkor érkeznek meg a kérdések:
- Melyik ügyféltábla számít a cégen belül hiteles nyilvántartásnak?
- Miért szerepel ugyanaz az ügyfél három különböző adószámmal?
- Ki döntötte el, hogy a lezárt üzlet az egyik rendszerben aláírt szerződést jelent, a másikban pedig kiállított számlát?
- Mely adatmezők kerülhetnek jogszerűen a modell elé, és ki hagyta jóvá ezt a felhasználást?
Ha több rendszerben ugyanannak az ügyfélnek eltérő adatai szerepelnek, önmagában az is data governance kérdéssé válik, hogy melyik rekord tekinthető hitelesnek. Erről a Melyik a hiteles ügyfélrekord → cikkünkben írunk.
Egy jól működő cégnél mindegyik kérdésnek van gazdája és a válasz percek alatt megvan. A többi cégnél ezek a kérdések a projektvezetőnél kötnek ki, aki utána több héten át járja az osztályokat, hogy végigkutassa az adatdefiníciókat. A projekt költségvetése ezt a kitérőt ritkán éli túl.
Hol romlik el az AI-projektek adatminősége
A RAND Corporation 2024-ben 65 tapasztalt adatelemzőt és mérnököt kérdezett meg arról, miért buknak el az AI-projektek. A tanulmány legtöbbet idézett becslése szerint az AI-projektek több mint 80%-a elbukik, ami a hagyományos informatikai projekteknél mért arány kétszerese.
Az adatokból eredő kudarcok a második leggyakoribb okot jelentik közvetlenül az üzleti vezetés döntései után. Az 50 iparági interjúalany közül 30-an maguktól hozták szóba a tartós adatminőségi problémákat, és többen ugyanazt a csapdát írták le. A vezetés a heti értékesítési riportok pontos érkezéséből arra következtet, hogy a cég adatai rendben vannak. A riportolási vagy megfelelőségi célra gyűjtött adat viszont túl kevés kontextust hordoz ahhoz, hogy modellt lehessen rajta tanítani.
A RAND iparági vezetőknek szóló ajánlása néven nevezi a megoldást. Ha a cég előre költ a data governance-t és a modellüzemeltetést támogató infrastruktúrára, akkor rövidülnek az AI-projektek, és több jó minőségű adat áll rendelkezésre a betanításhoz. A jelentés a halogatott beruházást a hosszabb átfutás és a magasabb bukási arány egyik okaként kezeli.
Mit takar a data governance egy AI-projektben
Papíron a data governance megfelelőségi programnak hangzik, és ez a nézőpont pénzbe kerül a cégeknek. A gyakorlatban egy AI-projekt körül öt működési kérdést tesz rendbe:
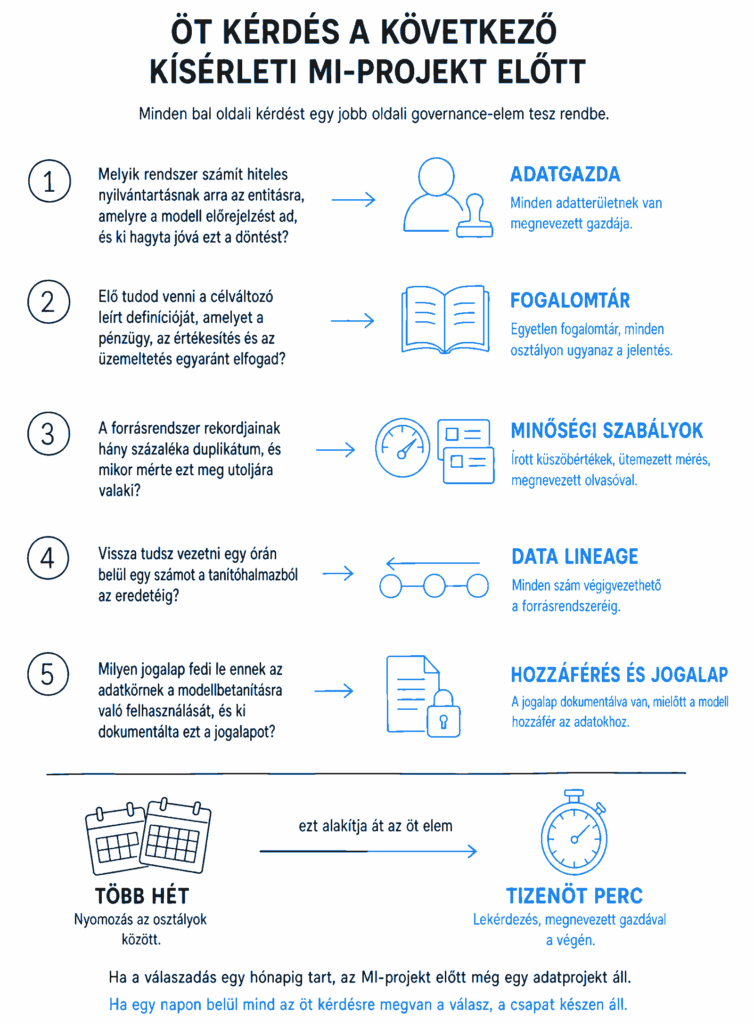
- Minden adatterületnek van kijelölt gazdája. Egy megnevezett adatgazda hagyja jóvá az adott terület definícióit, és ő felel azért, hogy ezek érvényben is maradjanak.
- A cég egyetlen fogalomtárt használ. Ebben rögzíti, mit jelent az ügyfél, az élő szerződés és a lezárt üzlet, és ugyanezt a jelentést használja a pénzügy, az értékesítés és az üzemeltetés is.
- Írott szabályok szerint méri a cég az adatállomány minőségét. Küszöbértékeket határoz meg a teljességre, a formátumra és a duplikációra, ütemezetten méri ezeket, az eredményt pedig egy megnevezett munkatárs olvassa el.
- A data lineage minden számot végigvezet a forrásáig. Bármelyik mutatószámról visszakövethető, hogy milyen átalakításokon ment át, és melyik forrásrendszerből származik.
- A hozzáférést és a jogalapot a nyilvántartás rögzíti. A cég leírja, melyik adatkör milyen célt szolgálhat, és a jogalapot még azelőtt dokumentálja, hogy a modell hozzáférne az adatokhoz.
Ez az öt elem a több hetes nyomozást tizenöt perces lekérdezéssé alakítja.
Az adatminőség csak az egyik feltétele annak, hogy az adatok alkalmasak legyenek az AI használatára. Az is fontos, hogy az adott célra megfelelően és jogszerűen lehessen felhasználni őket. Ezzel a kérdéssel Az AI adatvédelmi kockázatai →cikkünkben foglalkozunk.
Öt kérdést érdemes tisztázni a következő kísérleti AI-projekt előtt
- Melyik rendszer számít hiteles nyilvántartásnak arra az entitásra, amelyre a modell előrejelzést ad, és ki hagyta jóvá ezt a döntést?
- Elő tudja venni a célváltozó leírt definícióját, amelyet a pénzügy, az értékesítés és az üzemeltetés egyaránt elfogad?
- A forrásrendszer rekordjainak hány százaléka duplikátum és mikor mérte ezt meg utoljára valaki?
- Vissza tud vezetni egy órán belül egy számot a tanítóhalmazból az eredetéig?
- Milyen jogalap fedi le ennek az adatkörnek a modellbetanításra való felhasználását, és ki dokumentálta ezt a jogalapot?
Az a csapat, amely egy napon belül mind az öt kérdésre válaszol, készen áll az AI-projektre. Annak a csapatnak pedig, amelynél a válaszadás egy hónapig tart, az AI-projekt előtt még egy adatprojekt áll.
Így érdemes sorrendbe tenni a munkát
A data governance rossz hírben áll: lassúnak és elvontnak tartják, ezért lecsúszik a fejlesztési tervről. A gyakorlatban viszont az első hasznos kör szűk. Válassza ki azt az egy felhasználási esetet, amelyet az üzleti oldal kér. Térképezze fel a hozzá tartozó három vagy négy rendszert, nevezzen ki mindegyikhez egy adatgazdát, írja le azokat a definíciókat, amelyeken a többi definíció múlik, és mérje meg egyszer a duplikációt. Közepes méretű cégnél ez két, legfeljebb három hetes feladat, és cserébe a korábban nyitott kockázatból árazható döntés lesz.
Ha a cég kihagyja ezt a munkát, a kihagyás ára csendben halmozódik. A Gartner a rossz adatminőség éves költségét egy átlagos szervezetnél legalább 12,9 millió dollárra teszi. Közepes méretű cégnél az abszolút összeg alacsonyabb, a mechanizmus viszont ugyanaz. Munkaórák mennek el számok egyeztetésére, döntések születnek utólag tévesnek bizonyuló számok alapján, és beruházások maradnak félbe.
A mérleg másik oldalán is van bizonyíték. A Precisely és a Drexel Egyetem LeBow College of Business közösen készített 2026 State of Data Integrity and AI Readiness című tanulmánya több mint 500 nagyvállalati adat- és elemzésvezető válaszain alapul. A kutatás szerint a governance-programot működtető cégek 71%-a tartja megbízhatónak a saját adatállományát, míg a governance-program nélkül működő cégeknél ez az arány 50%. Ugyanez a kutatás azt is megállapította, hogy azok a szervezetek hozzák ki a legtöbbet az AI-ból, amelyek a meglévő data governance-programjukat AI-felügyeletre terjesztették ki.
A Gartner 60%-os előrejelzése a feladott projektekről végső soron sorrendi kérdésre vezethető vissza. Azok a cégek, amelyek a data governance-t az AI-projekt első szakaszaként kezelik, megtartják a kísérleti projektjeiket. Azok a cégek pedig, amelyek utólagos takarításnak tekintik ezt a munkát, ugyanezzel az öt kérdéssel később és drágábban találkoznak.
Így kezdjen hozzá
Ha a cége AI-kezdeményezésre készül, és a fenti öt kérdésre egy napnál tovább keresné a választ, a strukturált felmérés a gyorsabb út.
A Helyzetkép 2-4 hét alatt óraszámokkal megmutatja, hol van a legtöbb kiváltható kézi munka, melyik folyamatra melyik megoldás való, és mivel érdemes kezdeni. A végén rövid jelentést kap, amelyet a vezetés elé is letehet.
Ha ez az oldal hasznos volt, a hírlevél is az lesz.
Havonta egy levél a vállalati AI, adat és folyamatok gyakorlatáról, hazavihető tanulsággal. Bármikor leiratkozhat.
Források
- Gartner. (2020). Data Quality. A rossz adatminőség évi 12,9 millió dolláros átlagos költségbecslésének forrása. Cikk megnyitása →
- Gartner. (2025. február 26.). Lack of AI-Ready Data Puts AI Projects at Risk. A projektek feladására vonatkozó 60%-os előrejelzés és az AI-ra felkészített adatkezelési gyakorlatokra vonatkozó 63%-os adat forrása. Cikk megnyitása →
- Precisely & Drexel University LeBow College of Business. (2026). 2026 State of Data Integrity and AI Readiness. A 71%-os és 50%-os adatbizalmi értékek, valamint a data governance AI-felügyeletre való kiterjesztéséről szóló megállapítás forrása. Cikk megnyitása →
- RAND Corporation. (2024. augusztus). The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed. A 80%-os bukási becslés, az adatminőségi problémákra vonatkozó eredmények és a data governance infrastruktúrájára vonatkozó ajánlás forrása. Cikk megnyitása →

Fekszi Csaba
Fekszi Csaba informatikai szakértő, több mint két évtizedes tapasztalattal az adatmérnökség, a rendszerarchitektúra és az AI-alapú folyamatoptimalizálás területén. Munkájának középpontjában olyan skálázható megoldások tervezése áll, amelyek mérhetően javítják az üzleti eredményt.
Hol akadnak el a cége adatai?
Kapcsolódó cikkek
Miért akad el olyan sok AI-projekt, és hogyan léphet végre túl a pilotfázison